【第743期】编程化工具调用:超越JSON的LLM智能体演进
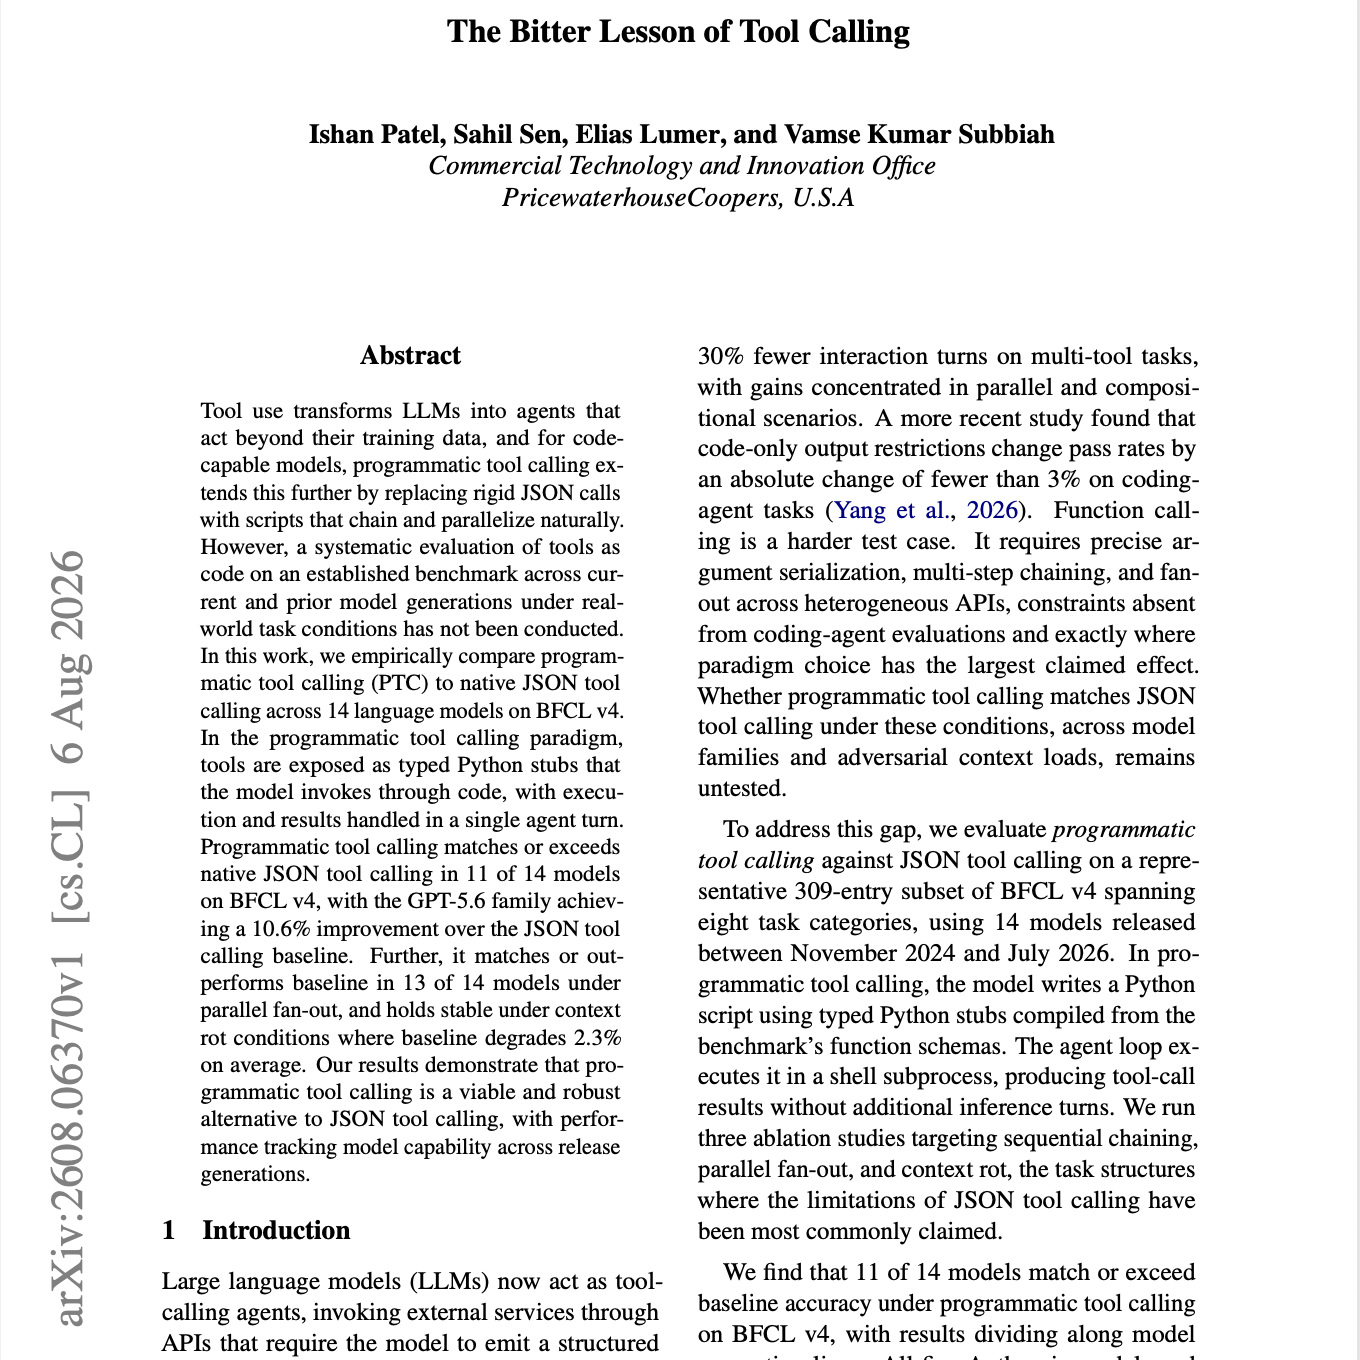
今天的这篇的主题是: The Bitter Lesson of Tool Calling Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 工具的使用将大语言模型(LLM)转化为能够超越其训练数据采取行动的 Agent;而对于具备代码能力的模型而言,程序化工具调用(programmatic tool calling)通过将僵硬的 JSON 调用替换为能够自然地进行链式连接与并行处理的脚本,进一步拓展了这一能力。然而,在现实任务条件下,基于既有基准对跨越当前及前几代模型的代码化工具进行系统性评估的工作此前尚未有人开展。 在本文中,我们在 BFCL v4 基准测试上,实证地将 14 个语言模型上的程序化工具调用(PTC)与原生 JSON 工具调用进行了对比。在程序化工具调用范式下,工具被暴露为带类型定义的 Python 存根(stubs),模型通过代码来调用它们,并在单个 Agent 回合内完成执行与结果处理。 在 BFCL v4 上,14 个模型中有 11 个模型的程序化工具调用表现达到或超过了原生 JSON 工具调用,其中 GPT-5.6 系列相较于 JSON 工具调用基线取得了 10.6% 的提升。此外,在扇出(fan-out)并行场景下,它在 14 个模型中的 13 个上达到或优于基线;并且在上下文腐烂(context rot)条件下保持稳定,而此时基线性能平均下降了 2.3%。 我们的结果表明,程序化工具调用是 JSON 工具调用的一种可行且鲁棒的替代方案,其性能表现随着模型迭代世代的能力提升而同步增长。 原文链接:https://arxiv.org/abs/2608.06370 前往小宇宙评论区与主播互动