transcript
show notes
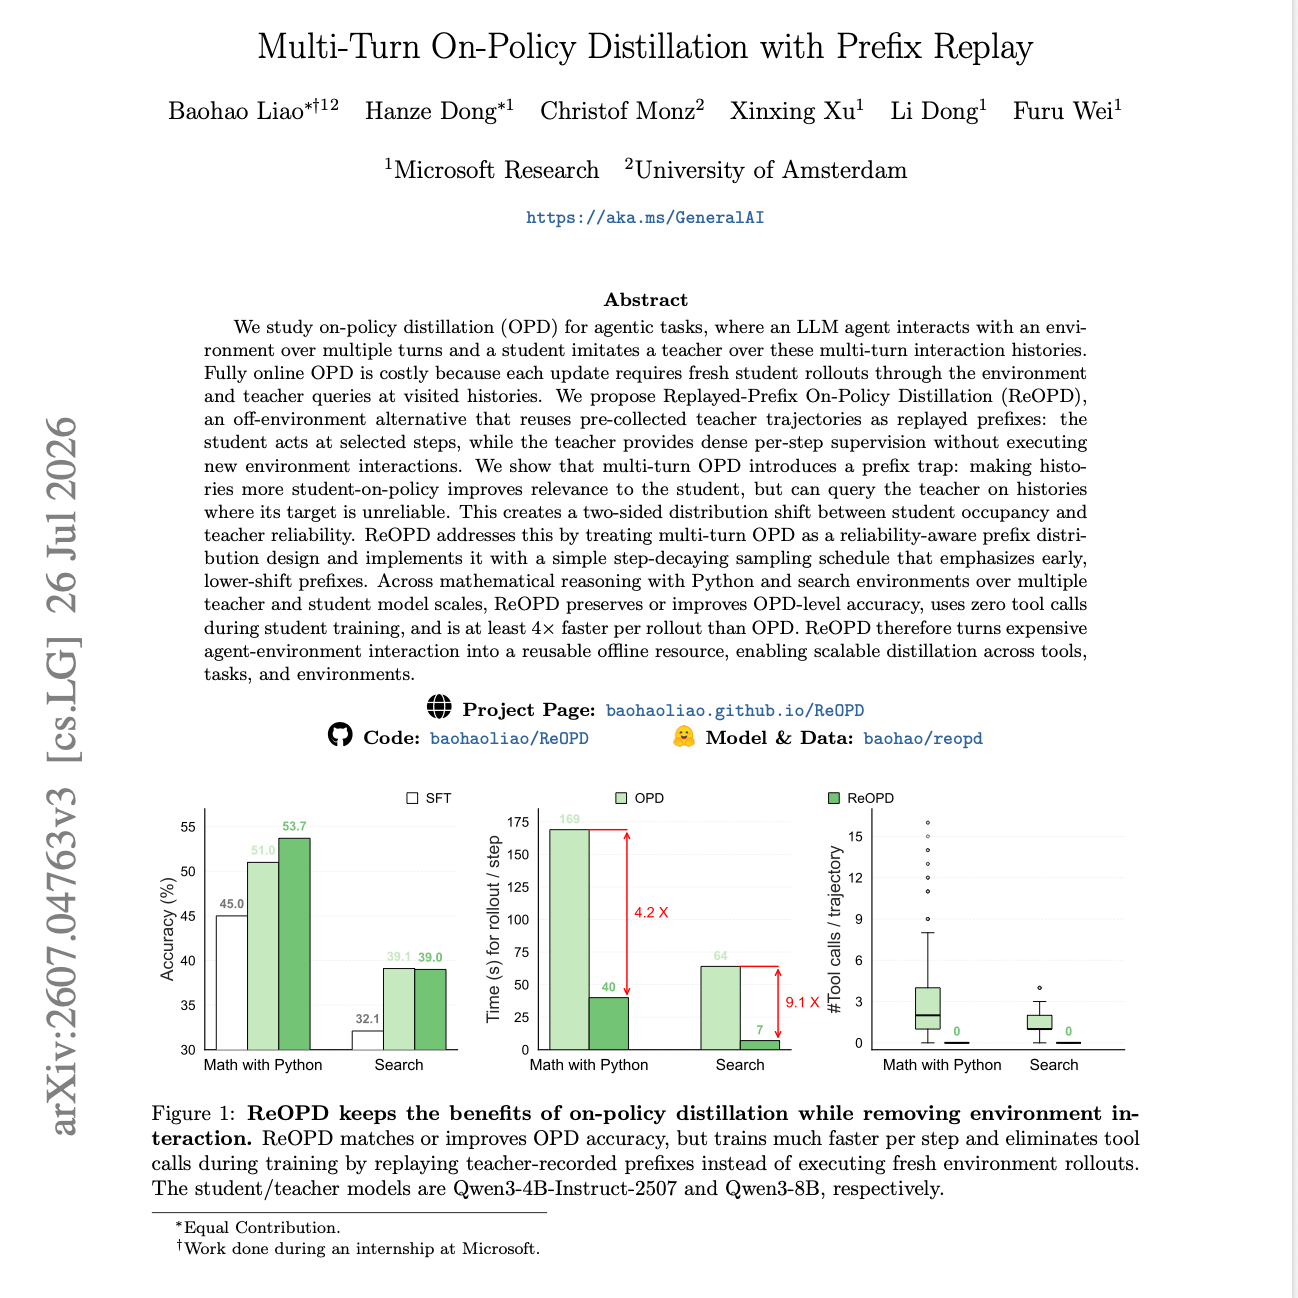
今天的这篇的主题是: Multi-Turn On-Policy Distillation with Prefix Replay
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
我们研究了针对 Agent 任务的在线策略蒸馏(On-policy Distillation, OPD)。在这些任务中,大型语言模型(LLM)Agent 跨越多个轮次与环境进行交互,学生模型在这些多轮交互历史中对教师模型进行模仿。完全在线的 OPD 成本极高,因为每一次更新都需要学生模型在环境中进行全新的采样(rollouts),并在所访问的历史节点处向教师模型发起查询。
我们提出了重放前缀在线策略蒸馏(Replayed-Prefix On-Policy Distillation, ReOPD),这是一种离线环境(off-environment)的替代方案,它将预先收集的教师轨迹复用为重放前缀:学生模型在选定的步骤执行动作,而教师模型提供密集的逐步监督,无需执行新的环境交互。
我们展示了多轮 OPD 会引发一个“前缀陷阱”(prefix trap):提高历史轨迹对学生在线策略的适配度(student-on-policy)能够提升其对学生模型的相关性,但却可能在教师模型目标不可靠的历史节点上对其发起查询。这就构成了学生模型占有率(student occupancy)与教师模型可靠性之间的双向分布偏移(two-sided distribution shift)。
ReOPD 通过将多轮 OPD 视为一种感知可靠性的前缀分布设计来解决这一问题,并通过简单的时间步衰减采样调度(step-decaying sampling schedule)加以实现,该调度侧重于早期、分布偏移较低的前缀。在结合 Python 的数学推理以及跨多种教师和学生模型规模的搜索环境实验中,ReOPD 保持或提升了 OPD 级别的准确率,在学生训练期间实现零工具调用,且每次采样的速度比 OPD 提升了至少 4 倍。因此,ReOPD 将昂贵的 Agent-环境交互转化为了可复用的离线资源,实现了跨工具、跨任务和跨环境的可扩展蒸馏。
原文链接:https://arxiv.org/abs/2607.04763
前往小宇宙评论区与主播互动