Skip to content
Artwork for Seventy3
Seventy3 · Friday · 12 min

【第740期】偷取思维链:针对大模型加密推理轨迹的提取攻击

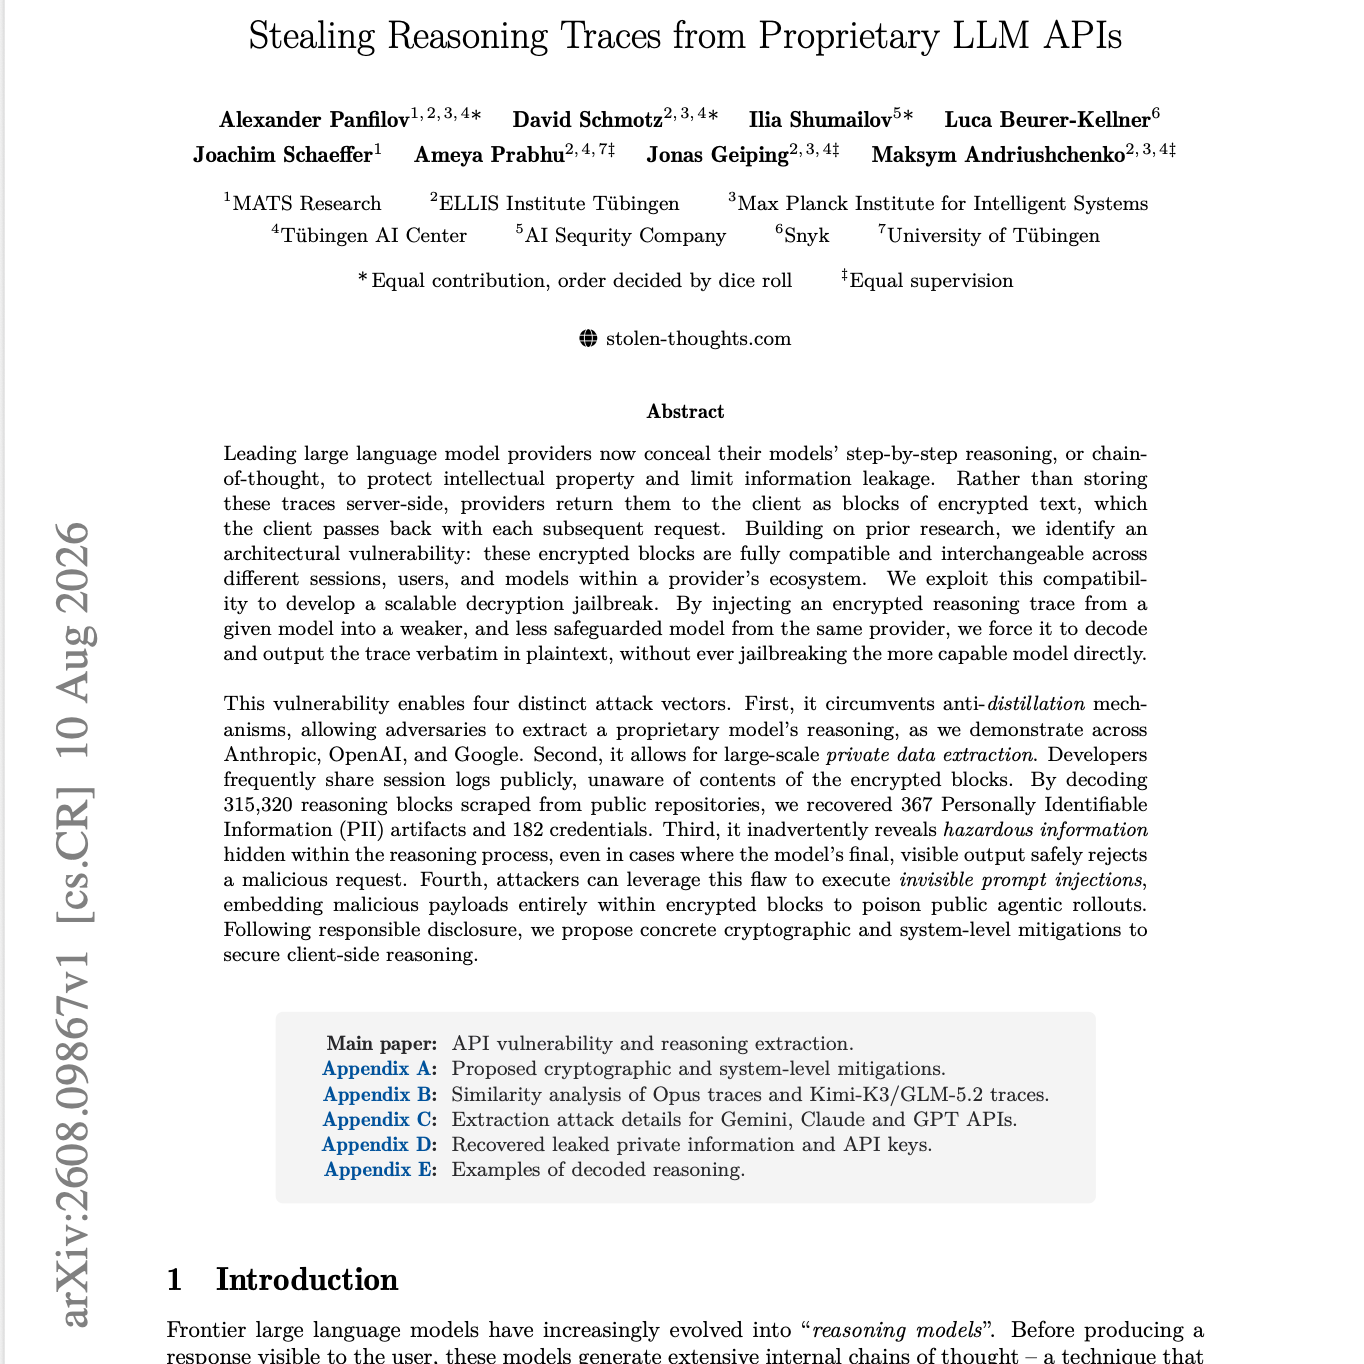
今天的这篇的主题是: Stealing Reasoning Traces from Proprietary LLM APIs Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 主要的语言模型(LLM)提供商如今会隐匿其模型的逐步推理过程(即思维链,Chain-of-Thought),以保护知识产权并减少信息泄露。提供商并非将这些轨迹存储在服务器端,而是将其作为加密文本块返回给客户端,由客户端在随后的每次请求中原样传回。基于先前的研究,我们发现了一个架构层面上的漏洞:这些加密文本块在同一提供商生态系统内的不同会话、用户和模型之间是完全兼容且可互换的。 我们利用这种兼容性开发了一种可扩展的解密越狱(decryption jailbreak)攻击。通过将来自给定模型的加密推理轨迹注入到同一提供商旗下更弱、防护更少的模型中,我们能够迫使该弱模型以明文形式逐字解码并输出该轨迹,而无需直接越狱能力更强的原模型。 这一漏洞衍生出了四种不同的攻击路径: 绕过反蒸馏机制:允许对抗者提取专有模型的推理过程,这一点我们在 Anthropic、OpenAI 和 Google 上均进行了验证。 实现大规模私密数据提取:开发者常在不了解加密块内容的情况下公开分享会话日志。通过解码从公开代码库中抓取的 315,320 个推理块,我们恢复出了 367 个个人身份信息(PII)构件和 182 个凭据(credentials)。 隐蔽揭示危险信息:即使模型最终可见的输出安全地拒绝了恶意请求,该漏洞也能揭示隐藏在推理过程中的危险信息。 执行隐形提示词注入(Invisible Prompt Injections):攻击者可利用此缺陷将恶意载荷完全嵌入加密块中,从而污染公开的智能体(agentic)运行轨迹。 在遵循负责任的漏洞披露原则后,我们提出了具体的密码学与系统级缓解措施,以保障客户端推理的安全。 原文链接:https://arxiv.org/abs/2608.09867 前往小宇宙评论区与主播互动

0:00-12:29

transcript

No transcript — this publisher did not publish one.

show notes

今天的这篇的主题是: Stealing Reasoning Traces from Proprietary LLM APIs

Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。

如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。

联系小助手微信:eccstartup(加群/投稿论文)

Summary

主要的语言模型(LLM)提供商如今会隐匿其模型的逐步推理过程(即思维链,Chain-of-Thought),以保护知识产权并减少信息泄露。提供商并非将这些轨迹存储在服务器端,而是将其作为加密文本块返回给客户端,由客户端在随后的每次请求中原样传回。基于先前的研究,我们发现了一个架构层面上的漏洞:这些加密文本块在同一提供商生态系统内的不同会话、用户和模型之间是完全兼容且可互换的。

我们利用这种兼容性开发了一种可扩展的解密越狱(decryption jailbreak)攻击。通过将来自给定模型的加密推理轨迹注入到同一提供商旗下更弱、防护更少的模型中,我们能够迫使该弱模型以明文形式逐字解码并输出该轨迹,而无需直接越狱能力更强的原模型。

这一漏洞衍生出了四种不同的攻击路径:

  1. 绕过反蒸馏机制:允许对抗者提取专有模型的推理过程,这一点我们在 Anthropic、OpenAI 和 Google 上均进行了验证。

  2. 实现大规模私密数据提取:开发者常在不了解加密块内容的情况下公开分享会话日志。通过解码从公开代码库中抓取的 315,320 个推理块,我们恢复出了 367 个个人身份信息(PII)构件和 182 个凭据(credentials)。

  3. 隐蔽揭示危险信息:即使模型最终可见的输出安全地拒绝了恶意请求,该漏洞也能揭示隐藏在推理过程中的危险信息。

  4. 执行隐形提示词注入(Invisible Prompt Injections):攻击者可利用此缺陷将恶意载荷完全嵌入加密块中,从而污染公开的智能体(agentic)运行轨迹。

在遵循负责任的漏洞披露原则后,我们提出了具体的密码学与系统级缓解措施,以保障客户端推理的安全。

原文链接:https://arxiv.org/abs/2608.09867


前往小宇宙评论区与主播互动
links2