Skip to content
Artwork for Seventy3
Seventy3 · October 3 · 12 min

【第734期】采样胜过反思:同等词元预算下的推理评估

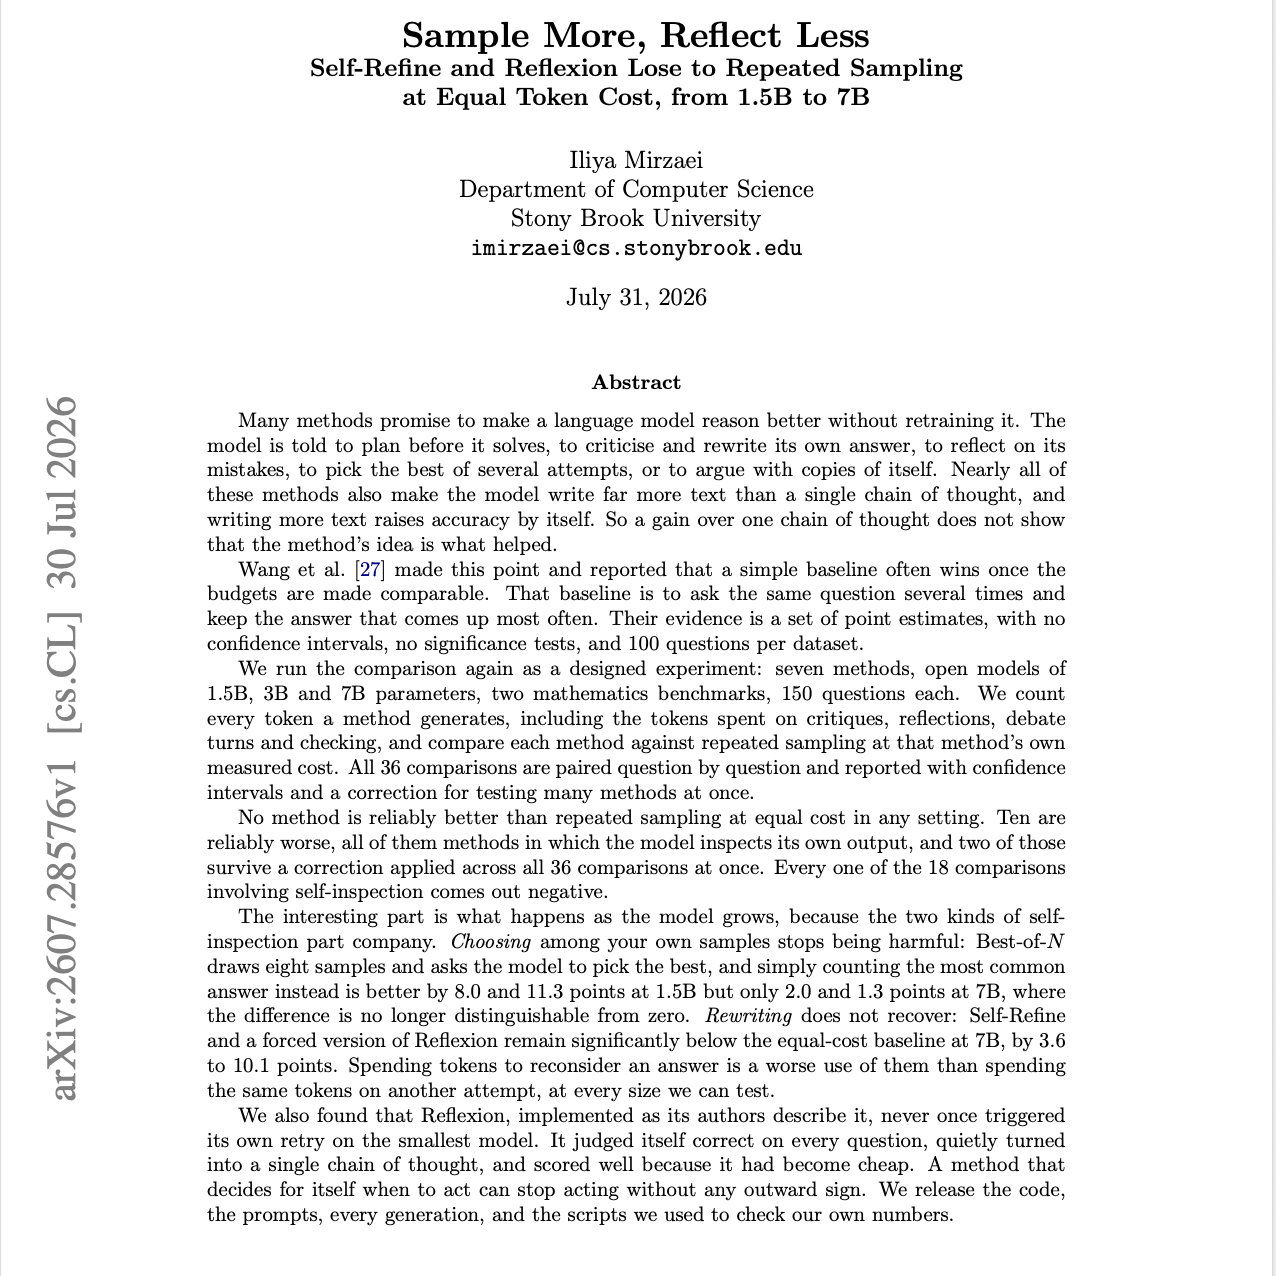
今天的这篇的主题是: Sample More, Reflect Less Self-Refine and Reflexion Lose to Repeated Sampling at Equal Token Cost, from 1.5B to 7B Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 让语言模型制定计划、批判并重写自身的回答、反思错误、从多次尝试中挑选最佳方案或与自身的副本进行辩论的方法,几乎都会使其生成比单条思维链(chain of thought)多得多的文本。由于仅通过生成更多文本本身就能提高准确率,因此相比单条思维链获得的性能提升并不能证明是该方法的核心构想发挥了作用。Wang 等人 (2024) 曾报告称,一旦控制预算相当,重复对同一个问题进行采样并保留最常见答案的简单基线往往能胜出,但该研究仅给出了点估计,缺乏置信区间或显著性检验。 我们将该比较重构为一项专门设计的实验:涵盖 7 种方法、参数量为 1.5B、3B 和 7B 的开源模型,以及两个数学基准测试(各含 150 道题目)。我们统计了生成的每一个 Token(包括用于批判、反思、辩论轮次和校验所消耗的 Token),并在各自实际测得的成本下,将每种方法与重复采样进行对比。所有 36 组对比均按问题进行了配对,并采用了 Self-bootstrap 采样区间与多重性修正(multiplicity correction)。 在相同成本下,没有任何方法在任何情况下能可靠地优于重复采样。有 10 组对比的结果可靠地更差,它们全部属于模型检查自身输出的方法,且所有 18 组自我检查(self-inspection)对比均为负向结果。随着模型规模的扩大,两类自我检查方法表现出了不同的走势。选择策略不再具有伤害性:取 Best-of-N 的 8 个样本并仅统计最常见的答案,在 1.5B 模型上比让模型自行挑选分别高出 8.0 和 11.3 个百分点,但在 7B 模型上仅高出 2.0 和 1.3 个百分点,与零相比已无法区分。重写策略则未能恢复:在 7B 模型上,Self-Refine 与强制 Reflexion 仍比基线低 3.6 到 10.1 个百分点。 原版论文中所发表的 Reflexion 在最小的模型上从未触发过自身的重试机制。它每次都判定自己是正确的,从而默默地退化为了单条思维链。我们公开了代码、提示词、所有生成内容以及我们的验证脚本。 原文链接:https://arxiv.org/abs/2607.28576 前往小宇宙评论区与主播互动

0:00-12:35

transcript

No transcript — this publisher did not publish one.

show notes

今天的这篇的主题是: Sample More, Reflect Less Self-Refine and Reflexion Lose to Repeated Sampling at Equal Token Cost, from 1.5B to 7B

Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。

如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。

联系小助手微信:eccstartup(加群/投稿论文)

Summary

让语言模型制定计划、批判并重写自身的回答、反思错误、从多次尝试中挑选最佳方案或与自身的副本进行辩论的方法,几乎都会使其生成比单条思维链(chain of thought)多得多的文本。由于仅通过生成更多文本本身就能提高准确率,因此相比单条思维链获得的性能提升并不能证明是该方法的核心构想发挥了作用。Wang 等人 (2024) 曾报告称,一旦控制预算相当,重复对同一个问题进行采样并保留最常见答案的简单基线往往能胜出,但该研究仅给出了点估计,缺乏置信区间或显著性检验。

我们将该比较重构为一项专门设计的实验:涵盖 7 种方法、参数量为 1.5B、3B 和 7B 的开源模型,以及两个数学基准测试(各含 150 道题目)。我们统计了生成的每一个 Token(包括用于批判、反思、辩论轮次和校验所消耗的 Token),并在各自实际测得的成本下,将每种方法与重复采样进行对比。所有 36 组对比均按问题进行了配对,并采用了 Self-bootstrap 采样区间与多重性修正(multiplicity correction)。

在相同成本下,没有任何方法在任何情况下能可靠地优于重复采样。有 10 组对比的结果可靠地更差,它们全部属于模型检查自身输出的方法,且所有 18 组自我检查(self-inspection)对比均为负向结果。随着模型规模的扩大,两类自我检查方法表现出了不同的走势。选择策略不再具有伤害性:取 Best-of-N 的 8 个样本并仅统计最常见的答案,在 1.5B 模型上比让模型自行挑选分别高出 8.0 和 11.3 个百分点,但在 7B 模型上仅高出 2.0 和 1.3 个百分点,与零相比已无法区分。重写策略则未能恢复:在 7B 模型上,Self-Refine 与强制 Reflexion 仍比基线低 3.6 到 10.1 个百分点。

原版论文中所发表的 Reflexion 在最小的模型上从未触发过自身的重试机制。它每次都判定自己是正确的,从而默默地退化为了单条思维链。我们公开了代码、提示词、所有生成内容以及我们的验证脚本。

原文链接:https://arxiv.org/abs/2607.28576


前往小宇宙评论区与主播互动
links2