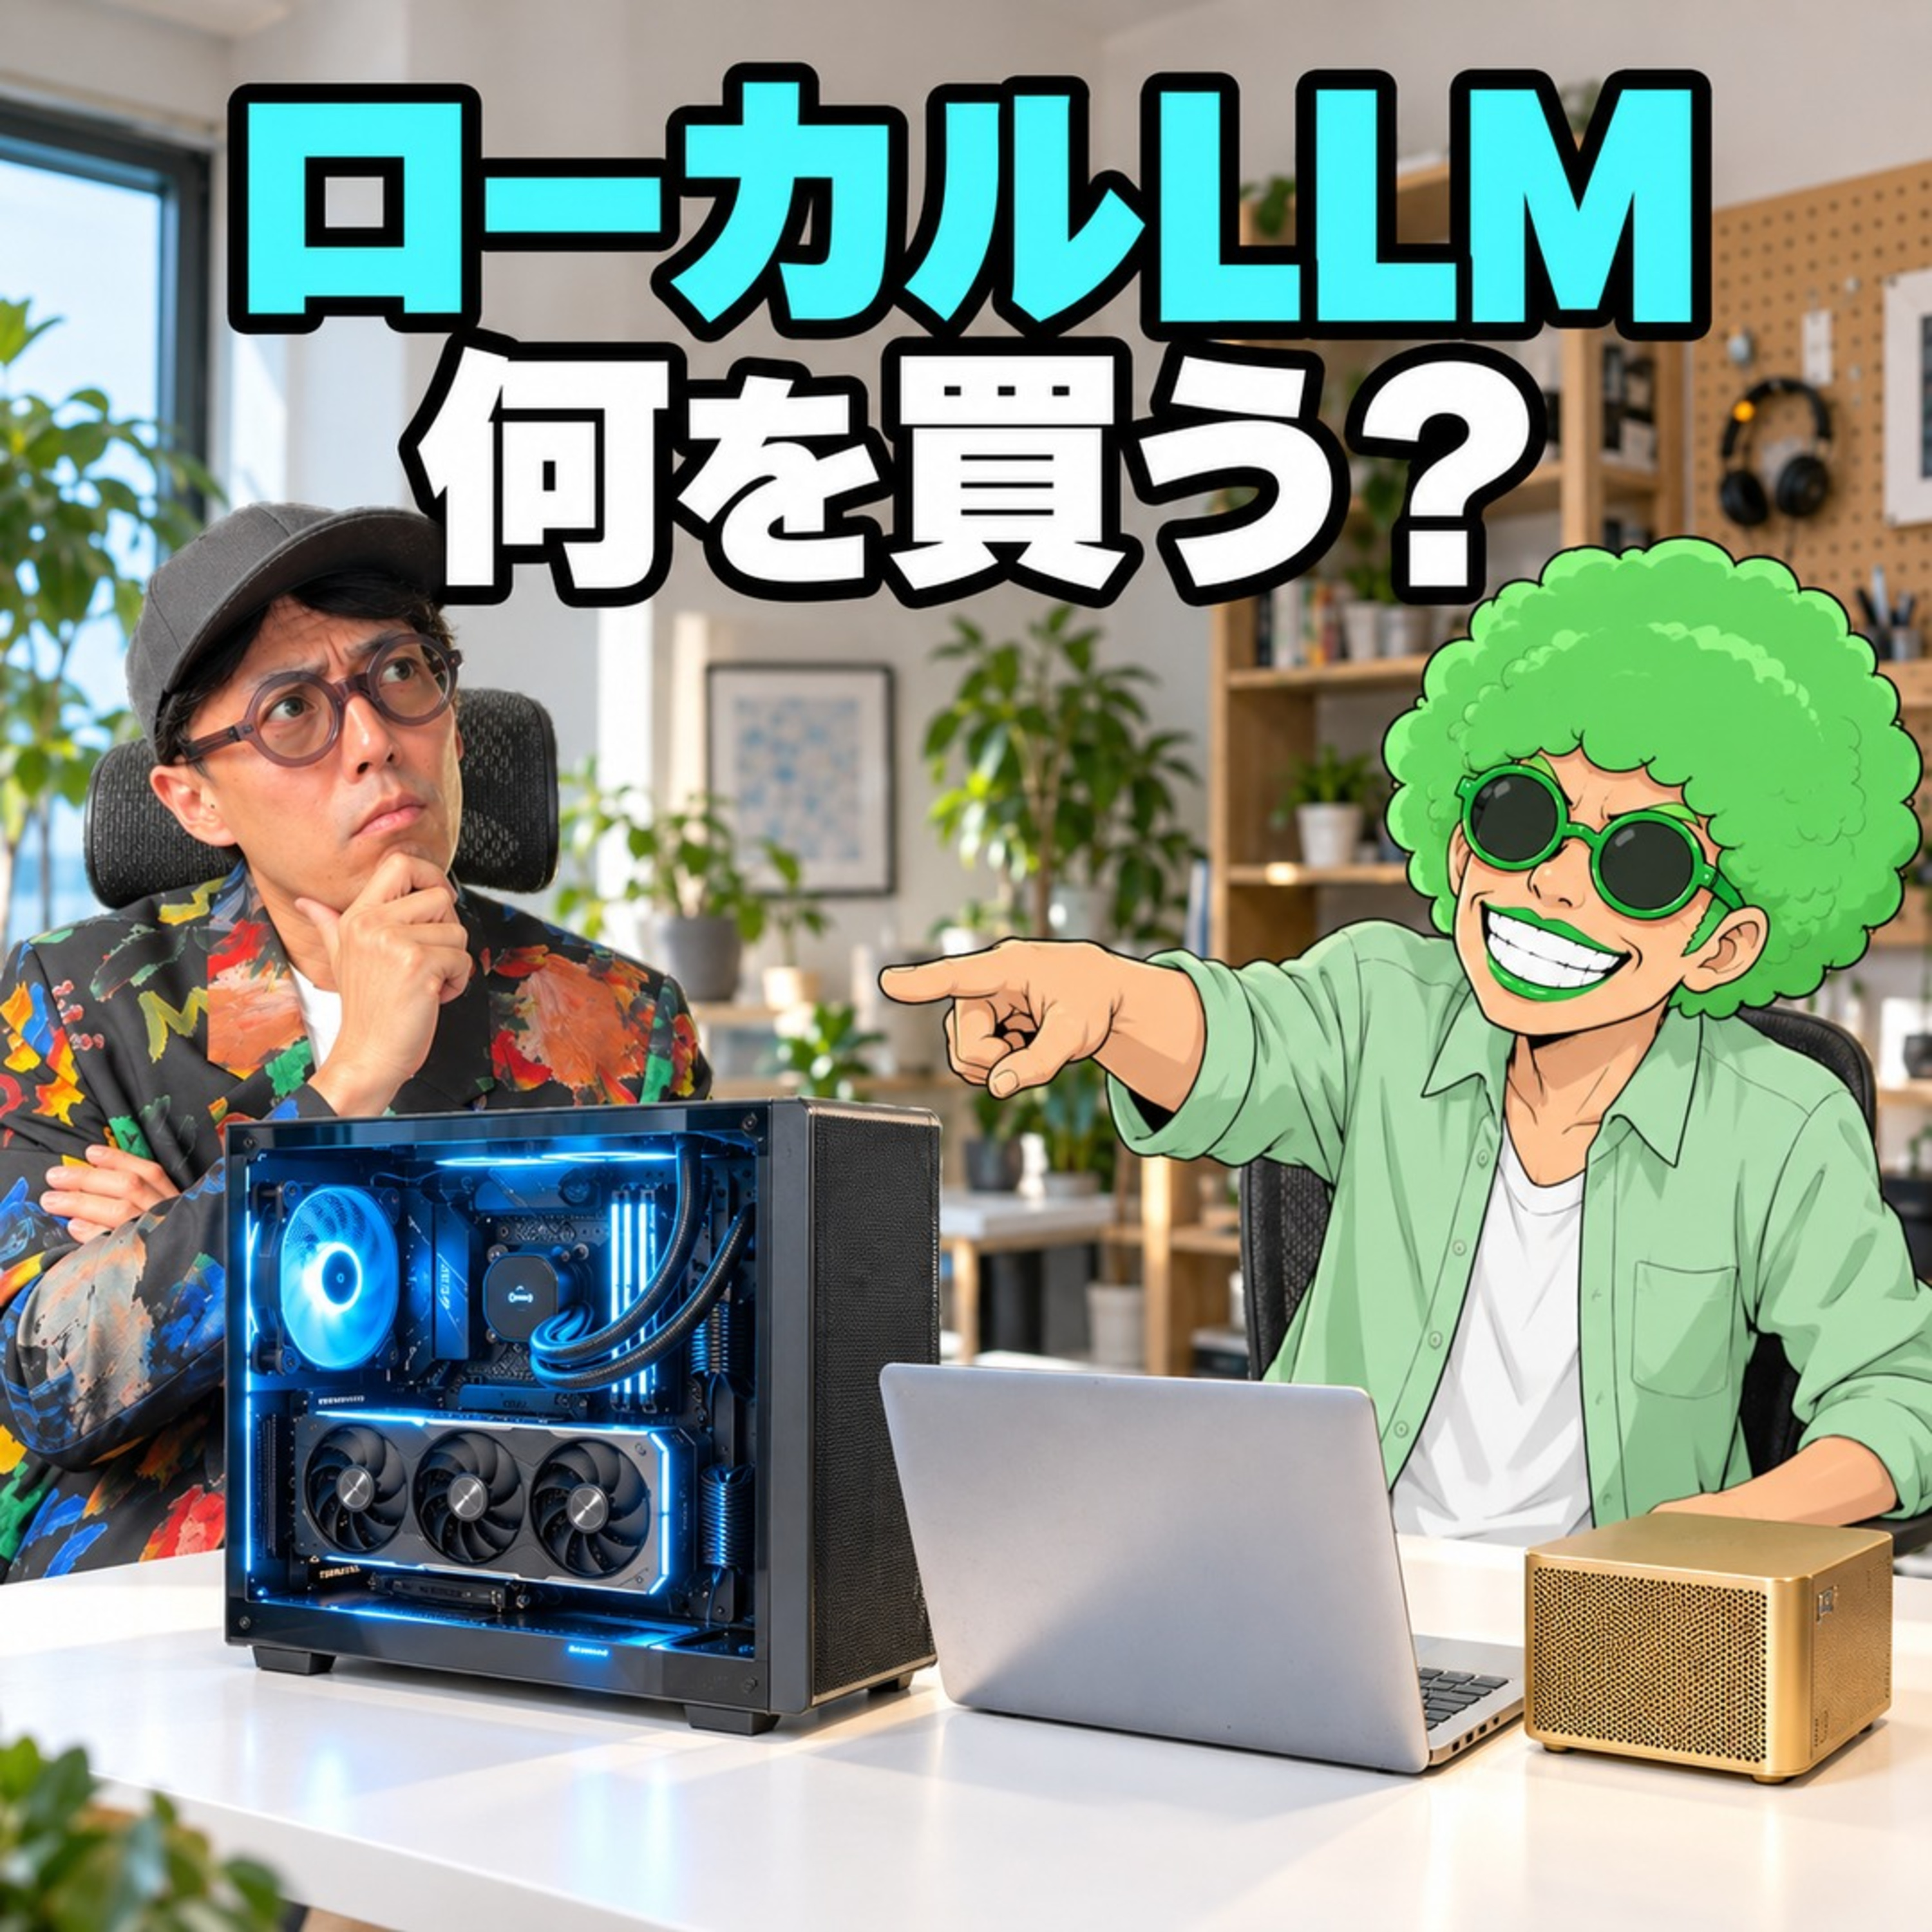
ローカルLLM用のPC、何を買う?RTX 3090か中古M1 MaxかDGX Sparkか(ep.109)
※収録日:2026/09/21 【公式切り抜きチャンネル、はじまりました】 おちつきAIラジオの公式切り抜き「おちつきAI【切り抜き】」を開設しました。1本15分前後で、本編のパートだけを切り出してお届けします。 ▼Spotify https://open.spotify.com/show/1ZDi70pwl9jQaLGD9mIDPq ▼Apple Podcasts https://podcasts.apple.com/jp/podcast/id6814639855 こちらもフォローと「★5」のレビューで応援してください。 【1周年祭のお知らせ】 初の単独イベント「おちつきAIラジオ 1周年祭 2026」を、2026年10月3日(土)に東京で開催します。 ▼「1年後のAI予測」投稿フォーム イベントに来られない方も、どなたでもご参加いただけます。事前に集めた予測を当日読み上げ、2周年イベントで答え合わせをします! https://forms.gle/xzgHP9AFfMgEUXGfA ▼1周年記念Tシャツは、まだ買えます https://ochitsuki-ai.com/e/1st/tee-pod 【トーク内容】 「ローカルLLM(自分のPCで動かすAI)を始めたいけど、何を買えばいいのか」。AI素人のかねりんが、現役AIエンジニアのしぶちょーに聞きます。目標は、いまローカルで定番のQwen3.8-27Bを手元で動かすこと。 CPU・GPU・RAM・VRAMの違いから、モデルを軽くする「量子化」、VRAMに入りきらない分を本体側に回す「CPUオフロード」まで。そのうえで、かねりんの自作PC(RTX 3090・VRAM 24GB+RAM 128GB)、中古で人気のM1 Max、約100万円のDGX Sparkを比べます。結論は「大事なのはVRAM」と「買う前に、小さいモデルとQwenのAPIで試してみる」。 後半は、電気代とマイニングの思い出、MacからWindowsへの乗り換えと水冷PC、睡眠の話、しぶちょーの近況まで。 【目次】 00:00:00 オープニング/今日はローカルLLMを動かすPCの話 00:06:01 本命モデルはQwen3.8-27B/脱線:R32 GT-Rの車検代 00:13:35 PCはレンタルしたい?なぜローカルで動かすのか 00:24:45 PCの基礎:CPU・GPU・RAM・VRAM。足りない分はCPUオフロード 00:38:27 かねりんのPCはRTX 3090+RAM 128GB。量子化で軽くする 00:43:51 Appleの統合メモリ:中古のM1 Maxが熱い 00:49:01 本命はDGX Spark、約100万円。AI発信者の背景には必須? 00:55:57 ローカルの電気代とマイニング/まずはLM Studioで 01:00:58 MacからWindowsへ:メモリ不足と自作PC・水冷 01:09:00 ゲームする時間がない/睡眠と健康、ショートスリーパーは本当か 01:22:48 話を戻して:まとめはVRAMが大事 01:28:00 結論:小さいモデルとQwenのAPIで試す/Qwen Code 01:33:08 しぶちょーの近況:YouTubeと登壇 01:39:21 エンディング 01:40:46 アフタートーク 【今回の放送回に関連するリンク】 【今回の要チェックキーワード】 Qwen(クウェン):Alibabaが開発するAIモデルのシリーズ。手元のPCで動かせる公開版もある。今回の主役はQwen3.8-27B。 ローカルLLM:外部のサーバーではなく、自分のPCでLLMを動かす方法。オフラインで使え、データを外へ送らずに済む。 CPU:PC全体の処理を受け持つ汎用の計算装置。LLMも動かせるが、速さを求めるならGPUを使う。 GPU:似た計算を大量にまとめて速く処理する装置。LLMの計算と相性がよく、生成の速さを左右する。 RAM:CPUが作業中のデータを置くメモリ。OSやアプリ、モデル、計算途中のデータが置かれる。 VRAM:GPU専用の高速なメモリ。何GBあるかで、動かせるモデルの大きさがほぼ決まる。 メモリ帯域幅:メモリから1秒間に運べるデータの量。容量が作業台の広さなら、帯域幅は運ぶ速さ。 SSD:モデルやアプリを保存しておく場所。容量が大きくても、RAMやVRAMの代わりにはならない。 27B:Bは10億(Billion)。約270億個のパラメータを持つという意味で、27GBという容量ではない。 パラメータ/重み:AIが学習で調整した大量の数値。モデルの中身そのもので、この数が27Bのような表記になる。 量子化:数値を少ないビット数で表してモデルを軽くする技術。27Bを16ビットから4ビットにすると重みは約54GBから約13.5GBに。 KVキャッシュ:すでに計算した文脈の情報を取っておく場所。会話や資料が長いほどメモリを使う。 CPUオフロード:VRAMに入りきらない分を本体のRAMに置き、CPUも使って動かす方法。動くが、GPUだけより遅い。 ユニファイドメモリ:CPUとGPUが同じメモリを共有する仕組み。Apple Siliconなどが採用し、大容量をGPUからも使える。 DGX Spark:NVIDIAの小型AI開発機。Arm CPUとBlackwell世代GPU、128GBの共有メモリを1台にまとめている。 tok/s(トークン毎秒):AIが1秒に何トークン生成できるかを示す速度の指標。大きいほど文字が速く出る。 LM Studio:ローカルLLMを画面の操作で探し、ダウンロードして、そのまま会話できるアプリ。入門の入口に向く。 —---------------------------- 【番組の概要】 日々のAIトピックを、現役のAIエンジニアがやさしく解説する対談番組。AIニュースに驚き疲れたあなたに、おちつきを提供します。AIニュースの、驚くポイント、驚かなくても良いポイントがわかります。 ★ご感想やコメントは、番組公式ハッシュタグをつけてX(旧Twitter)でポストしていただけるとありがたいです。 【番組公式Webサイト】※お便りはこちら https://ochitsuki-ai.com/ 【公式ツール】 ・おちつきAI RAG https://ochitsuki-airag.com/ 【番組公式ハッシュタグ】 #おちつきAI 【番組公式X】 https://x.com/ochitsuki_AI 【コミュニティの案内】 実践型の有料コミュニティで、みんなでAIを触っておちつこう! https://rooom.listen.style/p/ochitsuki-ai?tab=membership 【パーソナリティ(MC)】 ▼しぶちょー ・AIエンジニア ・技術士(機械部門) 「大手機械メーカーでAI開発の最前線を担う現役エンジニア。AI(ディープラーニング)の実装スキルを証明する「E資格」を保有。機械(ハードウェア)への高度な知見も有し、双方の専門性を掛け合わせ『AIの社会実装』に貢献する。情報発信活動にも精力的に取り組み、ブログ・音声配信(Podcast/Voicy)・SNSなどで幅広く活躍。単なる技術解説でなく、行動変容を伴う情報発信を信条とする。その姿勢が評価され、2025年UJA科学広報賞 審査員特別賞を受賞。著書に『集まれ設計1年生 はじめての締結設計』(日刊工業新聞社)。岐阜県テクノプラザものづくり支援センター広報大使、生成AI EXPO in 東海 共同代表も務める。」 https://x.com/sibucho_labo https://voicy.jp/channel/3963 ▼金田勇太(かねりん) ・KANERIN Podcast Studios 代表 ・一般社団法人 地方WEB3連携協会 理事 「刑事司法実務の最前線で多数の犯罪捜査を指揮。2017年から暗号資産業界へ参入。数々のグローバルプロジェクトに参画しコンサルティング、情報分析・アドバイザリー業務を提供。コンサートライブ配信業、音声配信業、テックメディア創業等を経て、ポッドキャストレーベル兼プロダクション「KANERIN Podcast Studios」を創業。多様なパートナーと共に、未来へつなぐ声の原典を共創している。」 https://x.com/kanerinx https://voicy.jp/channel/2534 【制作】 番組演出(トーク・BGM・効果音):Aviv Haruta カバーアートデザイン:UTA プロデューサー:金田勇太(かねりん) 制作:KANERIN Podcast Studios 著作:株式会社KANERIN https://kanerin.co.jp LISTENで開く
- Transcript
- Chapters