Skip to content
Artwork for TryCatch.tv

TryCatch.tv

Judlup

// Aprender haciendo
// AWS Community Builder
// judlup@trycatch.tv
http://oferti.co
1k?

Play
  • 22 episodes
  • Avg 1 hr
  • Spanish
Counted on this page — what you have heard stays on this device, so it is not something the list can be paged by.
  • Today · 1 hr 14 min

    re:Invent Pathfinder: diseñando los componentes y roadmap del proyecto

    Pathfinder ya tenía definido el problema y la experiencia que queríamos construir. En esta sesión damos el siguiente paso: descubrir qué componentes necesita realmente el sistema y convertir ese diseño en un roadmap ejecutable. Partimos de las capacidades mínimas del MVP, identificamos qué responsabilidades necesita cada una y construimos progresivamente el mapa de componentes de Pathfinder. Durante el proceso aterrizamos la separación entre cliente, AWS Events, conocimiento, recomendaciones y Adaptive Learning Journey, además de tomar decisiones sobre TypeScript, DynamoDB, Amazon Bedrock, AgentCore, Strands Agents, Serverless Framework y CDK. Con ese contexto llevamos la definición de negocio, producto y tecnología a Kaddo para estructurar el roadmap. El resultado fueron cinco grandes iniciativas: fundación técnica del monorepo, integración con AWS Events API, motor de conocimiento y recomendaciones, experiencia de learning path y reflexión, y cierre del ciclo con la experiencia de demo. A partir de ellas también quedaron identificados 16 candidatos a Work Items. La idea central de la sesión es que antes de pedirle a un agente que escriba código necesitamos entender qué sistema estamos construyendo, qué responsabilidades existen y en qué orden tiene sentido construirlas.
  • Yesterday · 1 hr 11 min

    Kiro en el mundo real: cómo se está usando en equipos de software

    ¿Cómo se ve Kiro cuando deja de ser una herramienta para hacer demos y empieza a utilizarse dentro de equipos, procesos y sistemas reales? En este conversatorio hablamos con profesionales que ya están usando Kiro en escenarios de infraestructura, desarrollo, automatización de despliegues y adopción empresarial. Revisamos cómo trabajan con agentes especializados, steering, skills, MCP, Spec-Driven Development y pipelines, pero también los problemas que aparecen cuando estas prácticas empiezan a escalar. La conversación entra en temas que normalmente no aparecen en una demo: costos por exceso de contexto, resistencia al cambio, sistemas legacy, deuda técnica, confianza en el código generado, gobierno, métricas y ROI. También discutimos cómo cambia el rol del desarrollador cuando escribir código deja de ser el principal cuello de botella. El resultado es una mirada bastante práctica a lo que significa trabajar con IA en el mundo real: menos foco en generar código y más en arquitectura, contexto, validación, orquestación y criterio.

  • Thursday · 1 hr 2 min

    TinyFish: cómo conectar agentes de IA con la web

    Un LLM puede razonar sobre información, pero cuando necesita buscar, leer, navegar o interactuar con una página web, necesita herramientas que le permitan salir de su contexto. En esta sesión probamos TinyFish, una plataforma enfocada en darle esas capacidades web a aplicaciones y agentes de IA. Primero entendemos las diferencias entre Search, Fetch, Agent y Browser, cuándo tiene sentido utilizar cada uno y cómo cambia el nivel de autonomía cuando integramos TinyFish mediante MCP. Después hacemos el onboarding desde cero, conectamos TinyFish con un agente y ejecutamos pruebas reales de búsqueda y extracción. La prueba termina siendo especialmente interesante con el sitio de Reebok: Fetch encuentra rápidamente el límite del contenido estático, así que pasamos a un Web Agent para intentar navegar las 18 páginas del outlet. La ejecución tarda cerca de 45 minutos, consume alrededor de 57 pasos y consigue extraer 174 productos únicos, dejando claras tanto las capacidades como las limitaciones y el trade-off entre autonomía, tiempo y costo. La conclusión no es que todo deba resolverse con un Web Agent. Search, Fetch, Agent y Browser tienen costos y niveles de control diferentes; la decisión correcta depende del problema que realmente necesitamos resolver.

  • Wednesday · 44 min

    Que el agente diga “terminé” ya no es suficiente | Kaddo Lifecycle v2

    Dar contexto a un agente mejora mucho la calidad de lo que construye, pero aparece otro problema cuando termina: ¿cómo sabemos que realmente hizo lo que le pedimos? En esta sesión recorremos Kaddo Lifecycle v2, la evolución del ciclo de desarrollo de Kaddo para acompañar un cambio desde la intención inicial hasta su verificación. Vemos cómo un Work Item pasa por refinement, planning e Implementation Handoff antes de llegar al agente, y cómo el nivel de contexto se ajusta proporcionalmente al alcance de la tarea. Después de la implementación, el ciclo continúa con Implementation Evidence, Verification, knowledge drift y Learning. La idea es que “terminé” deje de ser suficiente: queremos saber qué cambió, qué validaciones se ejecutaron, si la implementación se desvió del plan y qué nuevo conocimiento debería regresar al proyecto. La idea central es que el desarrollo asistido por IA no debería terminar cuando el agente genera código; debería terminar cuando podemos explicar, verificar y aprender de lo que hizo.

  • Tuesday · 53 min

    Vamos a construir la aplicación del re:Invent con el Pathfinder

    AWS re:Invent tiene cientos de sesiones, workshops y actividades. El problema no es encontrar contenido, sino decidir qué vale la pena ver según lo que estás construyendo y el conocimiento que todavía te hace falta. De ahí nace re:Invent Pathfinder, un proyecto para convertir el catálogo del evento en una ruta de aprendizaje personalizada. re_invent-pathfinder-contexto-d… En esta sesión recorremos el contexto completo del proyecto: cómo detectar knowledge gaps, generar recomendaciones explicables, adaptar la ruta a medida que la persona aprende y organizar la experiencia antes, durante y después del evento. También revisamos la arquitectura propuesta con AWS Events API, API Gateway, Lambda, Amazon Bedrock, CloudWatch y Amplify, evitando agregar infraestructura que todavía no necesitamos. re_invent-pathfinder-contexto-d… Finalmente aterrizamos los milestones de construcción: primero detectar brechas y recomendar sesiones, después incorporar agenda y conflictos, y finalmente construir el ciclo adaptativo que recalcula qué conviene hacer a continuación. El proyecto será open source y se irá construyendo con la comunidad. re_invent-pathfinder-contexto-d… re_invent-pathfinder-contexto-d… La idea central es simple: Pathfinder no busca decirte qué sesiones son populares, sino entender qué estás construyendo para ayudarte a descubrir qué deberías aprender.

  • September 26 · 1 hr 4 min

    IA, agentes y carrera: cómo crecer sin perder el foco

    En esta sesión hablamos de varias cosas que están cambiando la forma en que desarrollamos software: cómo Kaddo está evolucionando y empezando a usarse en proyectos reales, cómo gestionar conocimiento entre sistemas, y qué pasa cuando dejamos de trabajar con un solo agente para empezar a ejecutar varias tareas en paralelo. También hablamos de Git worktrees, de usar modelos diferentes para planeación y ejecución, y de un problema que empieza a hacerse evidente con los agentes: la IA puede construir más rápido de lo que nosotros podemos revisar, entender y cambiar de contexto. La conversación termina llevándonos a carrera y crecimiento profesional: cómo diferenciarse cuando todos están aprendiendo lo mismo, por qué perseguir cada nueva herramienta puede terminar agotándonos, qué pesa cuando queremos pasar de senior a arquitecto, y por qué liderazgo, comunicación, criterio e impacto empiezan a importar más a medida que avanzamos. La idea que atraviesa toda la sesión es sencilla: no se trata de aprender todo lo nuevo que aparece, sino de construir una base sólida y saber hacia dónde queremos crecer.

  • September 24 · 1 hr 5 min

    Cómo desplegar infraestructura en AWS con Terraform | IaC desde cero

    En la sesión anterior definimos la arquitectura de Tryckers. En esta damos el siguiente paso: convertir esas decisiones en infraestructura desplegable y reproducible usando Terraform. Partimos de los servicios que ya habíamos seleccionado para AWS —Amplify, EC2, RDS PostgreSQL, ECR, S3, IAM y SSM— y construimos el flujo completo: definición del Work Item, generación de los archivos .tf, validación, terraform plan, revisión del dimensionamiento y finalmente terraform apply. Durante el ejercicio también usamos Kaddo para mantener trazabilidad entre lo que queríamos construir y los cambios realizados. Al final verificamos directamente en AWS que los recursos fueron creados y encontramos un pendiente real: Amplify quedó aprovisionado, pero todavía falta vincular correctamente el repositorio que deberá desplegar. La idea central de la sesión es sencilla: la arquitectura deja de ser solamente un dibujo cuando podemos reproducirla.

  • September 23 · 52 min

    Vibe Coding vs Spec-Driven Development con Kiro

    Construimos exactamente la misma aplicación dos veces con IA para comparar dos formas distintas de trabajar: primero con Vibe Coding, entregándole directamente la intención al agente, y después usando Specs de Kiro, pasando por requirements.md, design.md y tasks.md antes de implementar. El experimento fue Roomly, una pequeña aplicación para reservar salas. La versión Vibe llegó a una primera versión funcional en unos cinco minutos y resolvió correctamente varios casos, pero permitió crear una reserva en una fecha pasada. Con Specs, Kiro generó requisitos, diseño, arquitectura, tareas y una implementación más estructurada. También apareció el otro lado de la comparación: el proceso tomó bastante más tiempo y consumió muchos más créditos. Al final, la versión basada en Specs sí bloqueó correctamente la reserva en una fecha pasada y cumplió las reglas que probamos. La conclusión no es que un enfoque sea siempre mejor: Vibe Coding puede llevarte mucho más rápido al primer resultado; Specs agrega estructura, trazabilidad y claridad, pero también tiene un costo.

  • September 22 · 53 min

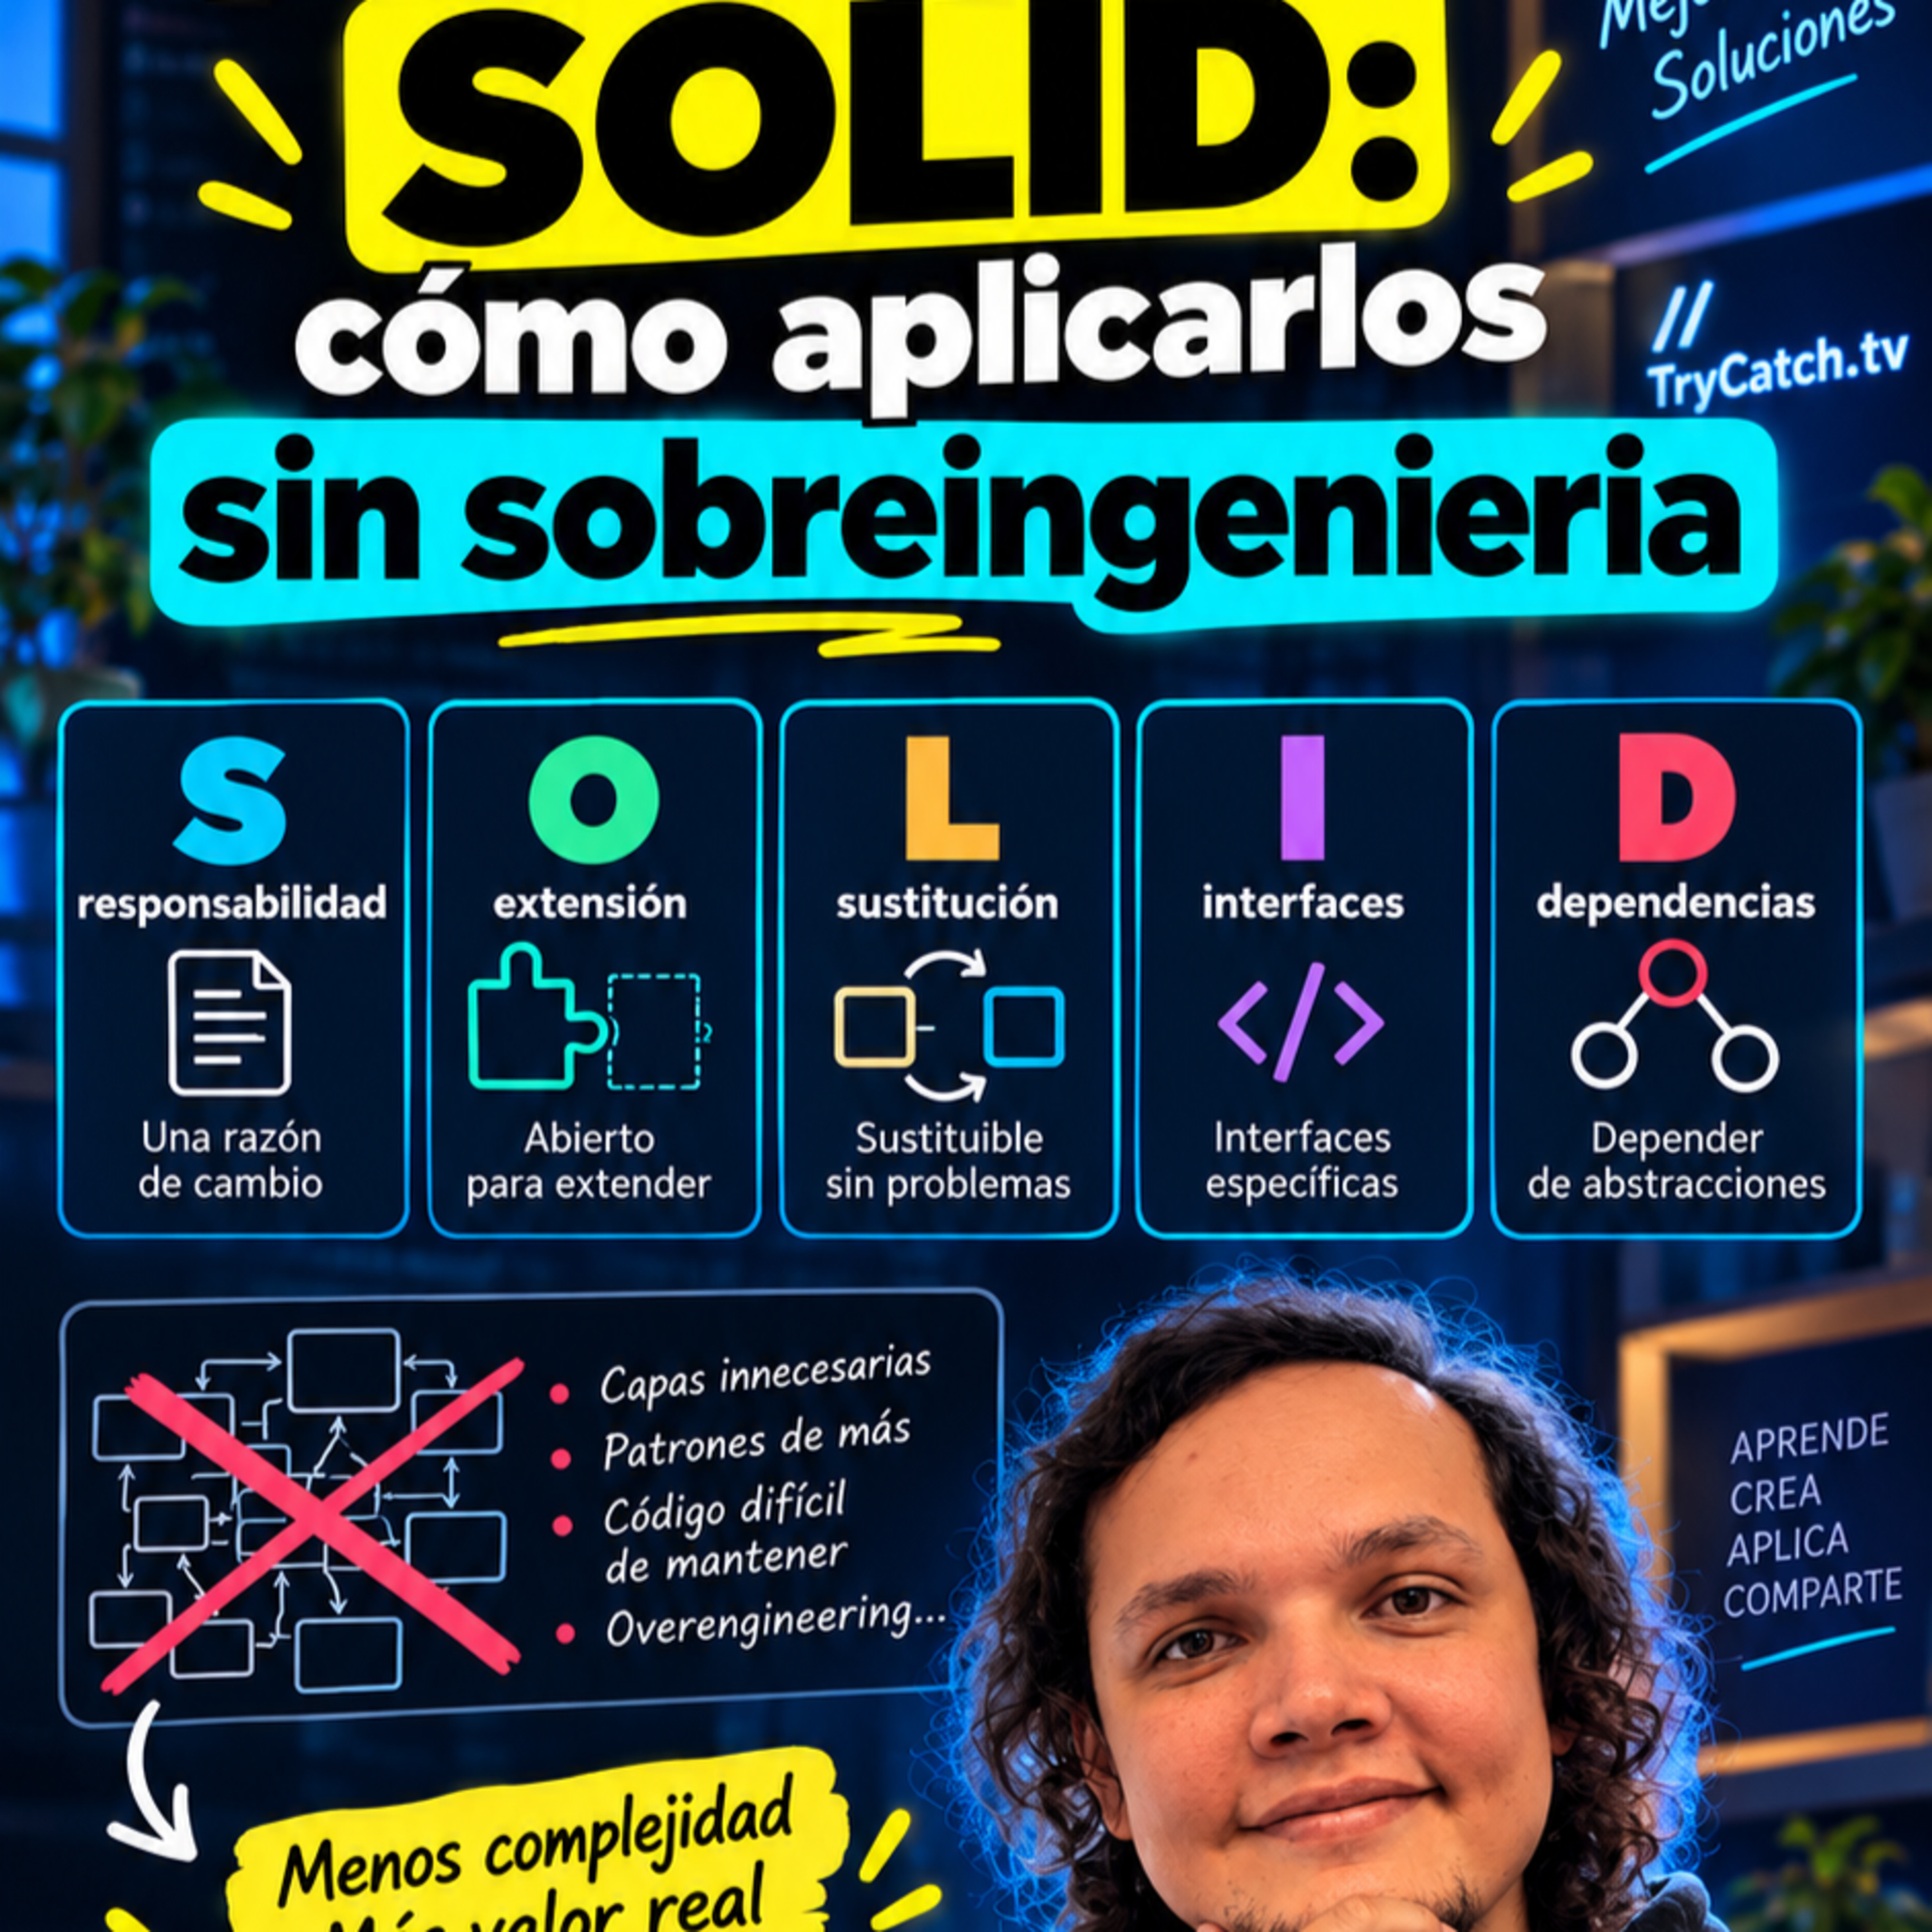
    Principios SOLID: cómo aplicarlos sin sobreingeniería

    SOLID suele enseñarse como cinco principios que todo buen proyecto debería aplicar, pero seguirlos sin entender el contexto también puede terminar haciendo el código más difícil de mantener. En esta sesión del capítulo 7 de Código Sostenible recorremos responsabilidad única, Open-Closed, sustitución de Liskov, segregación de interfaces e inversión de dependencias, pero desde una mirada práctica: qué problema resuelve cada principio, cuándo aporta valor y cuándo podemos estar agregando complejidad innecesaria. También hablamos de abstracciones, composición frente a herencia, inyección de dependencias y de por qué el criterio y la proporción siguen siendo más importantes que aplicar SOLID como una checklist. La idea central: SOLID no debería hacer que tu código parezca más sofisticado; debería hacer que cambiarlo sea menos peligroso.

  • September 16 · 57 min

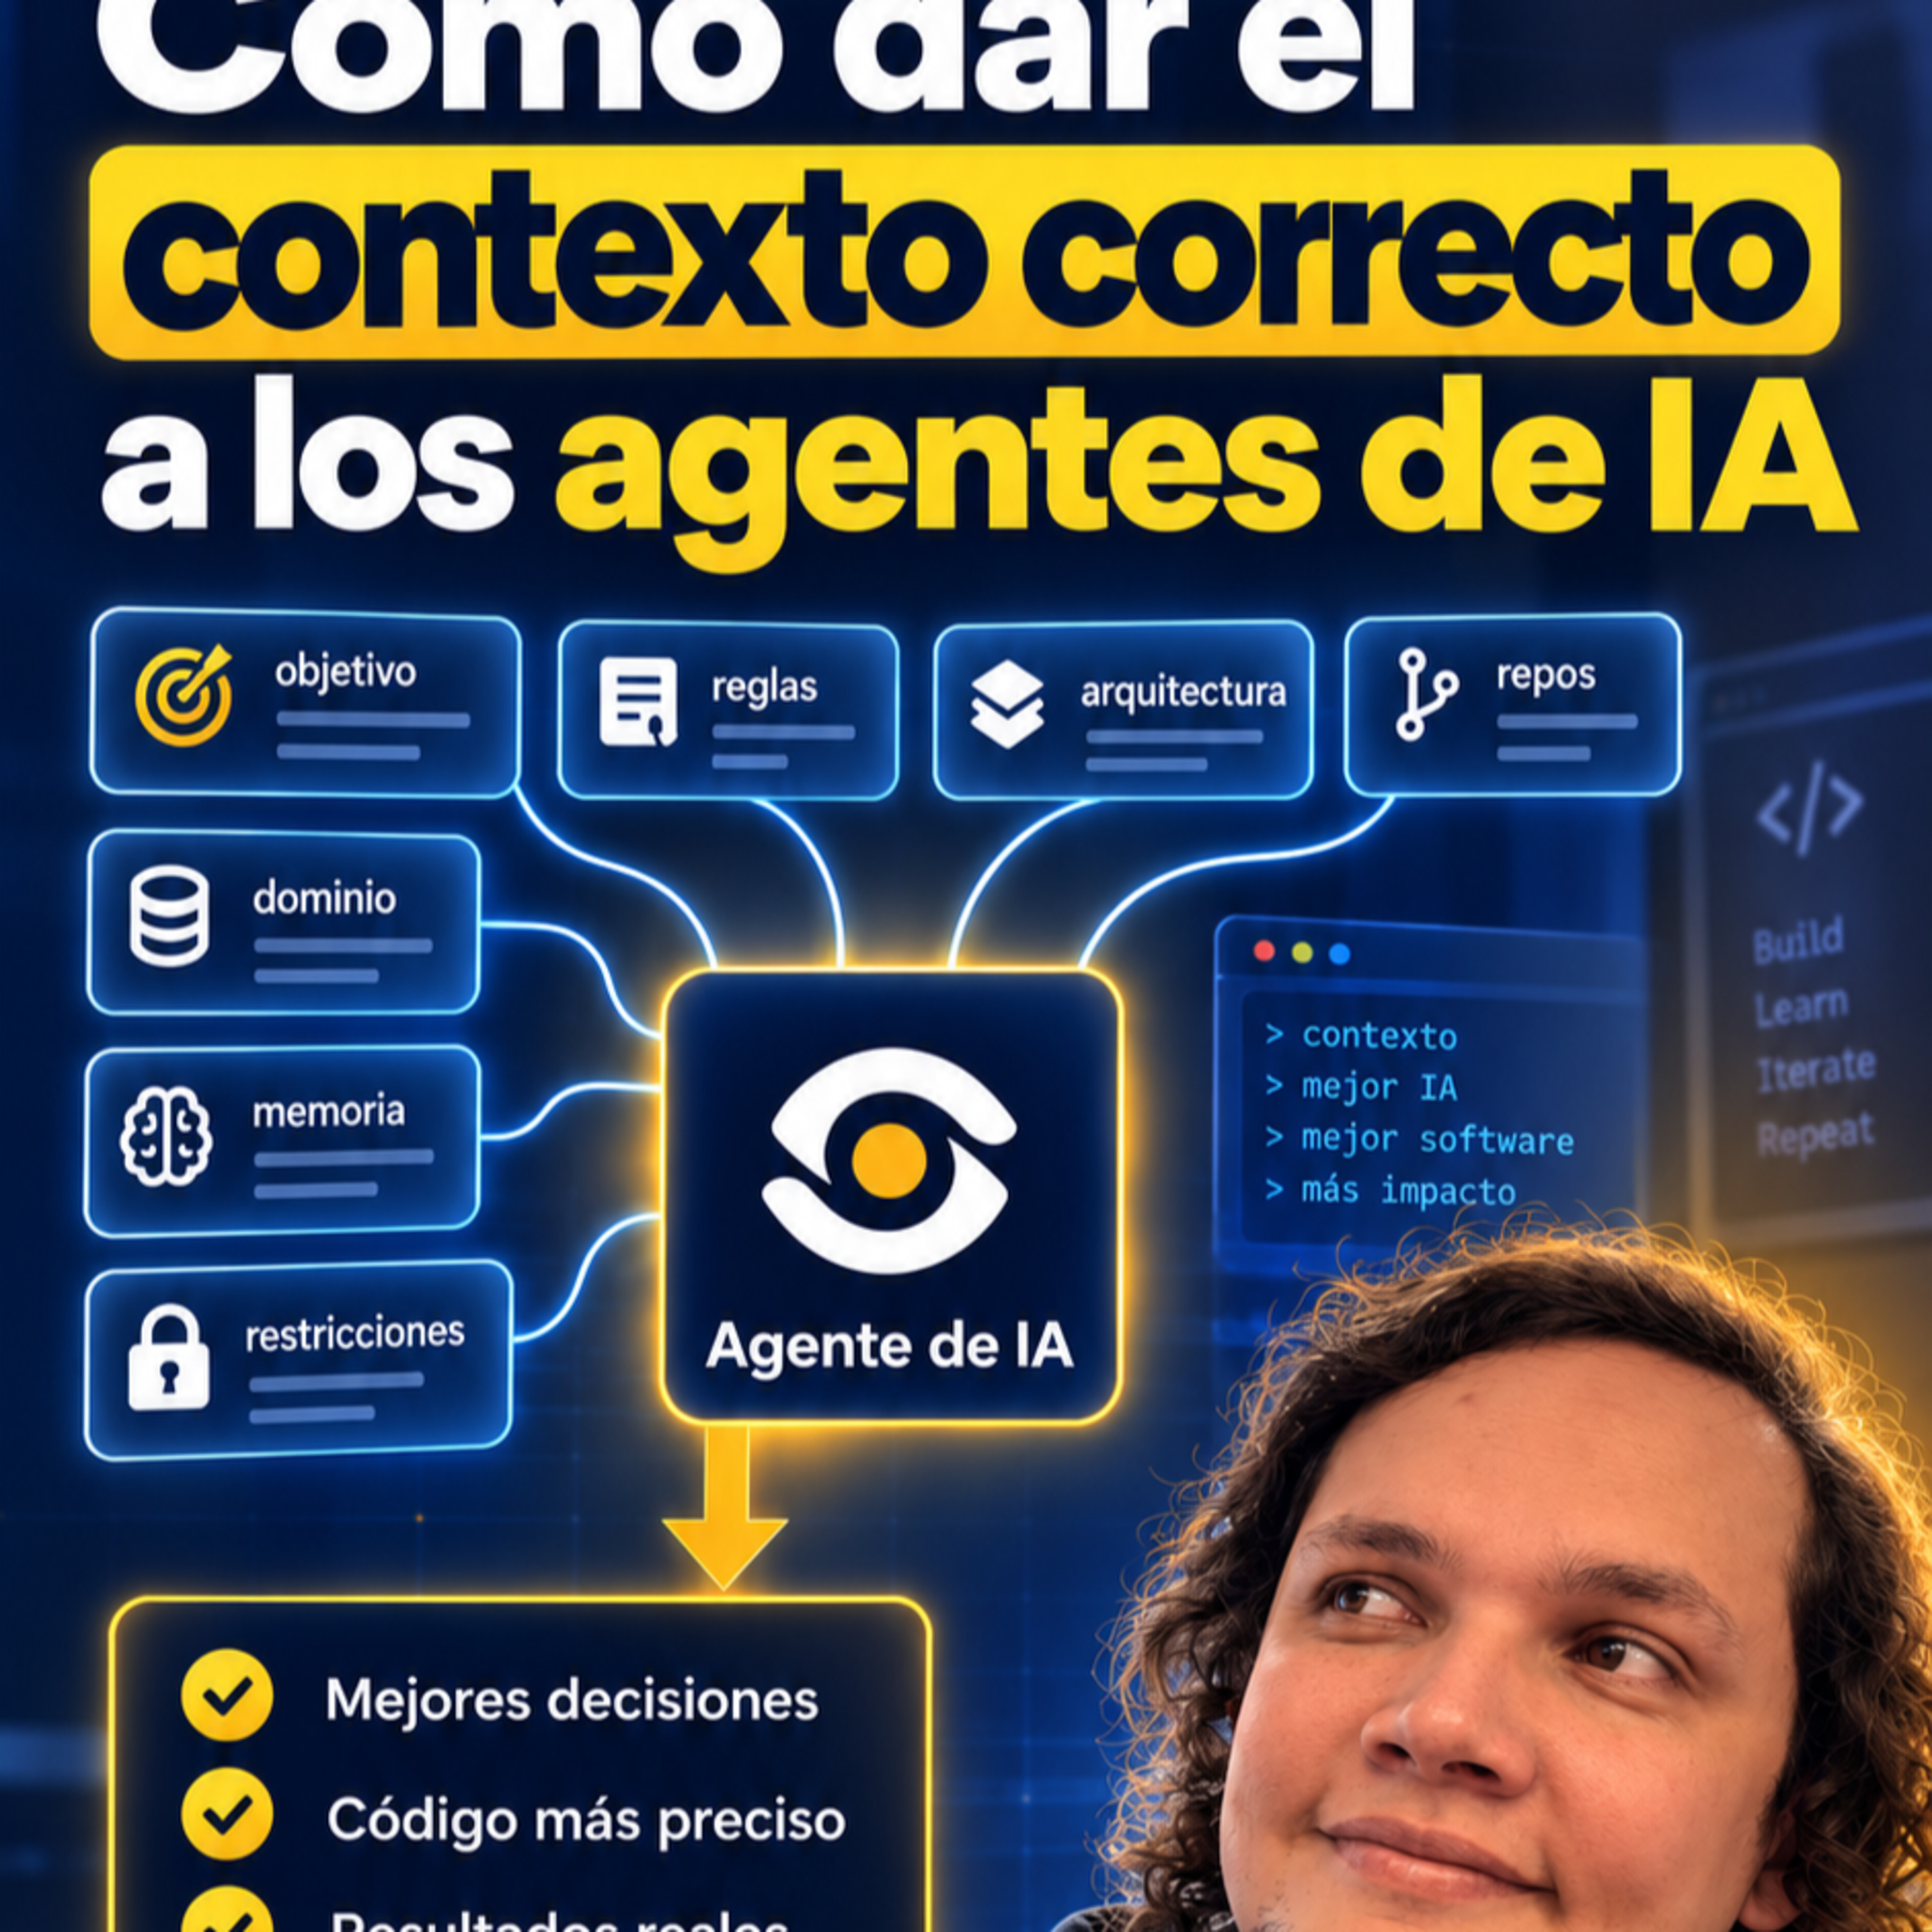
    Cómo dar el contexto correcto a los agentes de IA

    ¿Darle más contexto a un agente de IA siempre produce mejores resultados? No necesariamente. En esta sesión hablamos de cómo el conocimiento que necesita un agente debería crecer según el alcance de la tarea. No requiere lo mismo cambiar el texto de un botón que modificar un flujo completo de registro, donde ya entran APIs, base de datos, reglas de producto y otras partes del sistema. También vemos qué pasa cuando nos vamos al otro extremo y cargamos demasiado contexto, cómo encontrar ese conocimiento mínimo suficiente, qué cambia cuando crecen los equipos y cómo enrutar conocimiento entre módulos y repositorios sin obligar al agente a entender todo el sistema cada vez.Cerramos con un framework práctico para pensar el alcance, componentes, decisiones, riesgos, límites y criterios de aceptación antes de dejar que un agente empiece a construir.

  • September 12 · 1 hr 12 min

    Preguntas reales sobre carrera, IA y futuro del desarrollo de software

    En esta sesión dejamos la escaleta a un lado y respondimos preguntas de la comunidad sobre IA, desarrollo de software, aprendizaje, carrera, mercado laboral, proyectos y emprendimiento. La conversación pasó por cómo podría cambiar el código en un mundo cada vez más agent-native, qué aprovechar realmente de la universidad, cómo usar roadmaps sin intentar aprenderlo todo, qué está pidiendo hoy el mercado y por qué algunas vacantes empiezan a mezclar desarrollo, producto, negocio y comunicación en un mismo rol. También hablamos de proyectos personales, habilidades para vender lo que construimos, preparación para entrevistas, búsqueda de trabajo y hasta herramientas que ya están usando agentes para automatizar postulaciones. La idea que terminó conectando casi toda la sesión fue sencilla: las herramientas cambian muy rápido, pero criterio, fundamentos, comunicación y capacidad para resolver problemas siguen siendo cada vez más importantes.

  • September 11 · 1 hr 7 min

    Cómo vamos a llevar Tryckers a producción en AWS

    Retomamos Tryckers, el directorio open source de la comunidad, para revisar en qué estado está el MVP y definir qué necesitamos para llevarlo a producción. Durante la sesión evaluamos distintas opciones de infraestructura en AWS para el frontend, backend y base de datos, teniendo en cuenta algo clave: queremos aprender haciendo, pero sin sobrearquitectar ni gastar créditos innecesariamente. Comparamos alternativas como Amplify, S3 + CloudFront, EC2 + Docker, ECS/Fargate y RDS PostgreSQL, y terminamos definiendo una primera arquitectura que pueda evolucionar con el proyecto. La idea central: no se trata de usar más servicios de AWS, sino de escoger los suficientes para aprender, desplegar y poder evolucionar después.

  • September 10 · 53 min

    Cohesión y acoplamiento: cómo diseñar código sostenible

    En este episodio seguimos con la lectura de Código Sostenible, capítulo 6: Cohesión y acoplamiento. Hablamos de por qué estos dos conceptos funcionan como una brújula para tomar mejores decisiones de diseño: mantener juntas las cosas que realmente pertenecen juntas y reducir las dependencias innecesarias entre componentes. También recorremos ortogonalidad, dependencias cíclicas, inyección de dependencias, arquitectura hexagonal, Ley de Demeter, Tell, don’t ask y connascence para entender una pregunta fundamental: si cambio una parte del sistema, ¿cuántas otras estoy obligando a cambiar conmigo? La idea central: el código sostenible no elimina las dependencias; evita que cada dependencia termine convirtiéndose en una cadena difícil de romper.

  • September 9 · 1 hr 11 min

    Lo que aprendí participando en 6 eventos tech en un mes

    Durante casi un mes estuve mucho menos presente en las transmisiones de TryCatch.tv, pero fue porque la comunidad salió de la pantalla. Pasé por AWS Summit Bogotá, Latam Architecture Day, CaribeDev Barranquilla, Containers Day en República Dominicana, DevOps Day Lima y AWS Community Day Bolivia. En este episodio cuento cómo fue vivir esos eventos, viajar entre ciudades y países, participar como speaker y encontrarme cara a cara con personas que durante años solo había conocido por un username. Más allá de las charlas, quedaron conversaciones, comunidad, cansancio, aprendizajes y una confirmación importante: crear contenido y compartir conocimiento durante años termina abriendo puertas que muchas veces uno ni siquiera sabía que existían. La idea central: los eventos no valen solamente por lo que ocurre en el escenario, sino por las personas y conexiones que aparecen alrededor.

  • August 19 · 55 min

    Cómo tomar mejores decisiones de arquitectura en Google Cloud

    En este episodio hablamos de trade-offs reales en Google Cloud a partir de tres decisiones muy comunes: Cloud SQL vs Firestore, Cloud Run vs GKE y HTTP vs Pub/Sub. La idea no es decidir qué servicio es “mejor”, sino entender qué problema estamos resolviendo, qué atributo de calidad importa, qué complejidad introducimos y qué costo operativo estamos dispuestos a asumir. También hablamos de escala futura, sobrearquitectura, costo humano de la infraestructura, acoplamiento, asincronía, observabilidad e idempotencia. La conclusión: una buena decisión de arquitectura no elige la tecnología más poderosa, sino la que mejor encaja con el contexto actual y puede evolucionar cuando ese contexto cambie.

  • August 11 · 1 hr 22 min

    Terremoto en Colombia

    En este episodio hablamos sobre lo ocurrido durante el terremoto del 10 de agosto de 2026 en Colombia, partiendo de la experiencia personal, los reportes que se conocían durante la transmisión y los testimonios de personas en distintas ciudades. Más allá de las cifras, la conversación se centra en preparación, infraestructura, comunicaciones, sistemas de alerta, resiliencia y uso de la tecnología durante una emergencia. También revisamos cómo herramientas digitales pueden ayudar a ubicar personas, compartir información y coordinar respuestas, pero con una idea clave: en una emergencia, la velocidad de la información nunca debería estar por encima de su confiabilidad. La reflexión central: no podemos decidir cuándo ocurre un terremoto, pero sí podemos decidir qué tan preparados estamos cuando sucede.

  • August 5 · 37 min

    Principio de menor sorpresa aplicado al código

    En este episodio seguimos con la lectura de Código Sostenible, capítulo 5: Principio de menor sorpresa. Hablamos de por qué el código debería comportarse siempre de la forma en que otra persona espera, sin efectos secundarios ocultos, retornos inconsistentes ni abstracciones que obliguen al equipo a desconfiar. También analizamos métodos que mienten sobre lo que hacen, comentarios que intentan justificar diseños confusos, monkey patching y la diferencia entre ocultar secretos de implementación y esconder consecuencias inesperadas. La idea central: el buen diseño puede ocultar cómo funciona internamente, pero nunca debería ocultar qué provoca.

  • August 4 · 1 hr 32 min

    Cómo configurar Kaddo en un proyecto pre-IA y multirepo

    En este episodio configuramos Kaddo desde cero en el Directorio Trycker, un proyecto open source existente, pre-IA y compuesto por varios repositorios. Vemos cómo definir un repositorio core, mapear frontend y backend como módulos, reconstruir el conocimiento del sistema y preparar contexto para que los agentes no trabajen de forma aislada. También desarrollamos un work item de extremo a extremo para agregar la fecha de cumpleaños al perfil, cubriendo producto, privacidad, datos, backend, contrato, frontend, pruebas y actualización del conocimiento. La idea central: la IA puede leer todos tus repositorios y aun así no entender el producto; el contexto es lo que convierte archivos separados en un sistema.

  • July 24 · 44 min

    Cómo elegir mejores nombres en el código

    En este episodio seguimos con la lectura de Código Sostenible, capítulo 4: Técnicas para elegir nombres. Hablamos de por qué nombrar bien no es un detalle estético, sino una decisión de diseño que afecta cómo el equipo entiende, mantiene y evoluciona el software. Vimos heurísticas para elegir mejores nombres: que sean fáciles de pronunciar, que no incluyan ruido técnico innecesario, que eviten comodines como Helper, Manager o Utils, que formen frases naturales, que respeten el lenguaje del negocio y que se apoyen en el contexto correcto. La idea central: un buen nombre reduce la necesidad de explicar; un mal nombre obliga al equipo a adivinar.

  • July 22 · 53 min

    Holberton: El problema de vender sueños en la educación tech

    En este episodio analizamos el caso de Holberton y la discusión alrededor de programas de formación en tecnología que prometen estudiar ahora y pagar después. El objetivo no es hacer un linchamiento, sino entender el problema de fondo: qué pasa cuando la promesa de entrar a tech se mezcla con deuda, expectativas laborales, pagarés, contratos difíciles de entender y publicidad agresiva. También hablamos de la responsabilidad de las instituciones que venden educación, la responsabilidad de quienes firman este tipo de acuerdos y la realidad del mercado tech: aprender programación puede abrir oportunidades, pero no garantiza empleo automático. La idea central: la educación tech puede cambiar vidas, pero nadie debería hipotecar su futuro por una promesa mal explicada.

Showing 1–20 of 22 episodes