transcript
show notes
今天的这篇的主题是: Agent Lightning v1.0: Towards Harnessed Agentic RL
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
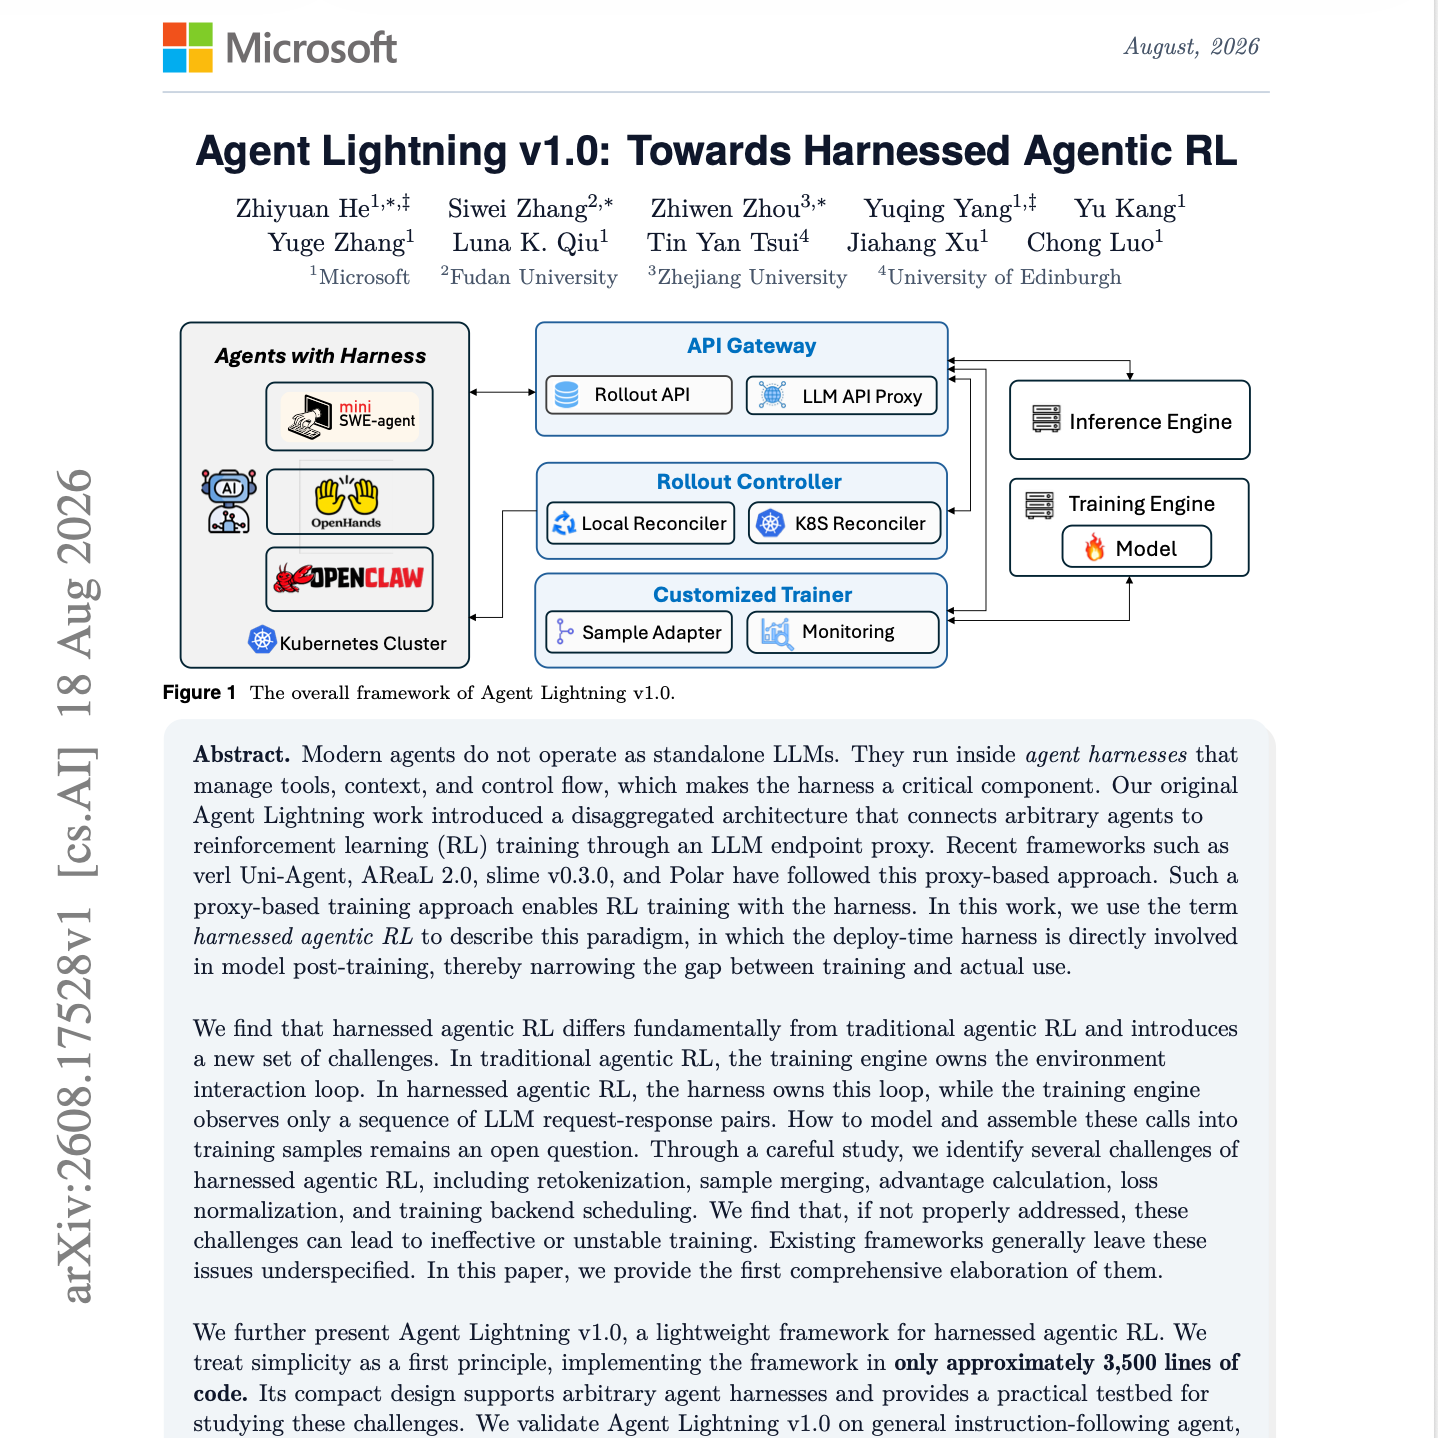
现代智能体运行在智能体运行框架(agent harness)之中,这些框架负责管理工具、上下文和控制流,因此成为智能体系统的关键组成部分。我们最初提出的 Agent Lightning 引入了一种解耦式架构(disaggregated architecture),通过大语言模型(LLM)端点代理将任意智能体连接到强化学习(RL)训练流程。此后,verl Uni-Agent、AReaL 2.0、slime 和 Polar 等框架也采用了这一方法。
我们将这一范式称为基于运行框架的智能体强化学习(harnessed agentic RL),即部署阶段使用的智能体运行框架直接参与模型的后训练过程。
基于运行框架的智能体强化学习与传统智能体强化学习存在根本区别:环境交互循环由运行框架而非训练引擎负责管理,而训练器只能观测到由 LLM 请求与响应组成的序列。这带来了重新分词(retokenization)、样本合并、优势值计算、损失归一化以及后端调度等方面的挑战,而这些因素都可能显著影响训练的稳定性和有效性。
我们提出了 Agent Lightning v1.0,这是一个轻量级的基于运行框架的智能体强化学习框架,仅使用约 3,500 行代码实现。它支持任意智能体运行框架,并为研究上述挑战提供了一个实用的实验平台。
我们在指令遵循、搜索和编程智能体上对该框架进行了评估,并提供了一套完整且可复现的编程智能体强化学习流程。
仅使用 6,000 条训练样本和适度的计算资源,强化学习便将 Qwen3.5-9B 在 SWE-bench Verified 上的表现从 41.8% 提升至 56.4%,实现了 14.6 个百分点的绝对提升。
我们公开了完整的工作流程和训练脚本,以促进基于运行框架的智能体强化学习领域的可复现研究。
原文链接:https://arxiv.org/abs/2608.17528
前往小宇宙评论区与主播互动