transcript
show notes
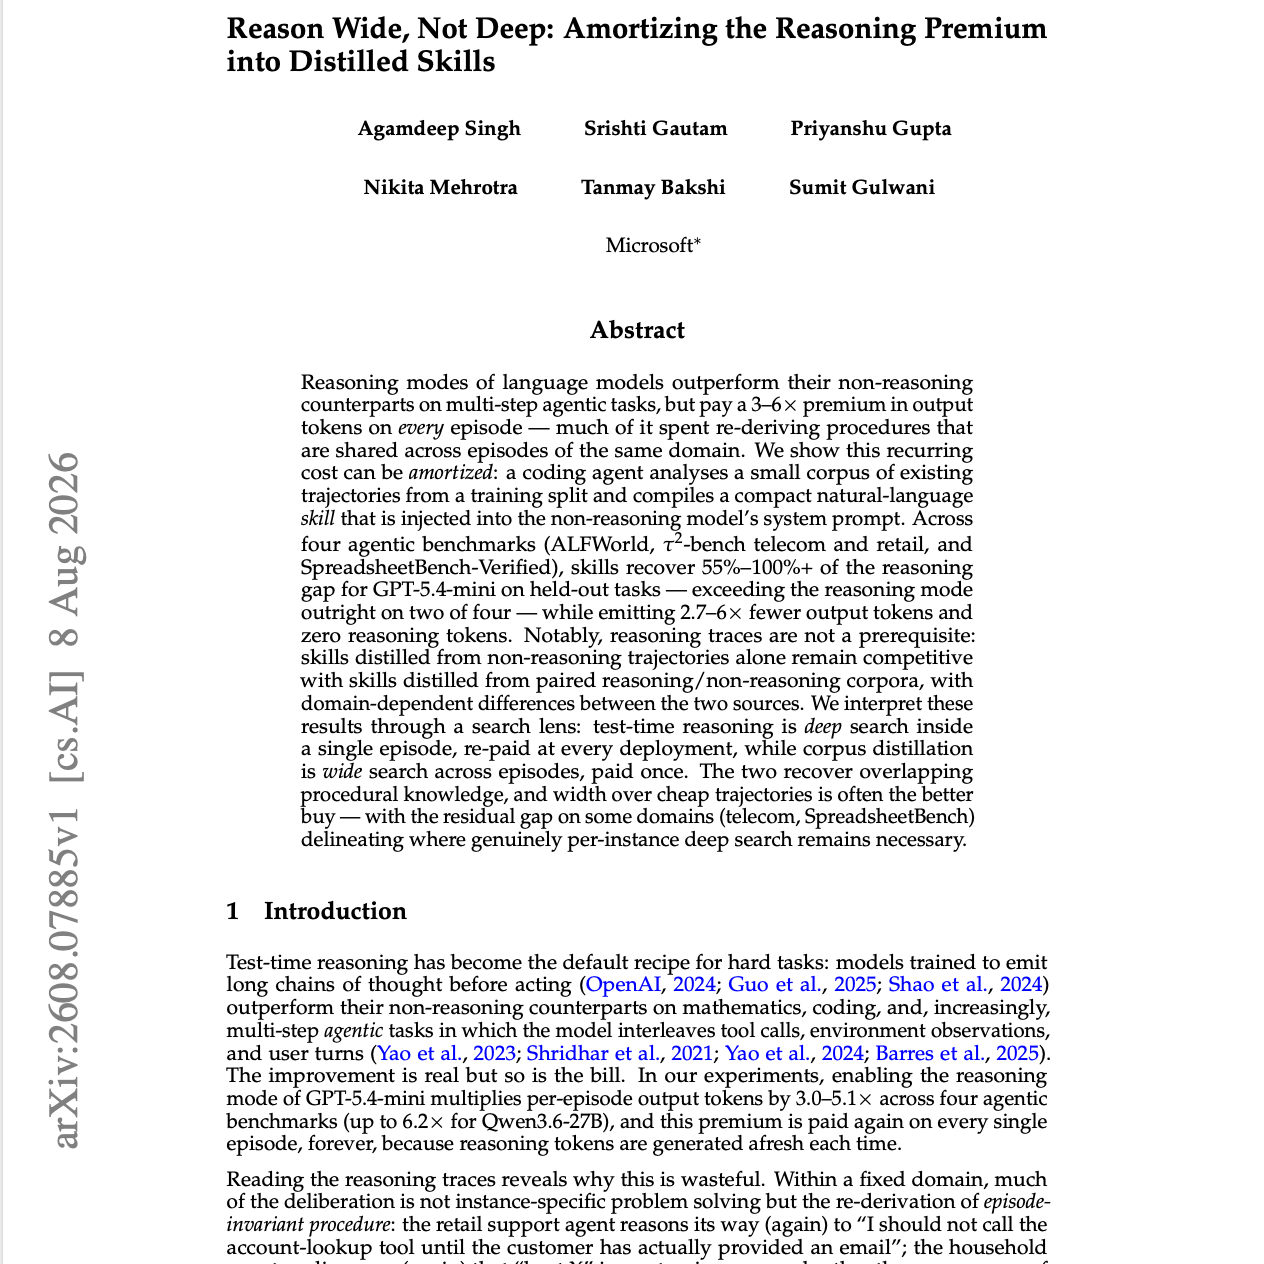
今天的这篇的主题是: Reason Wide, Not Deep: Amortizing the Reasoning Premium into Distilled Skills
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
语言模型的推理模式(reasoning modes)在多步 Agent 任务上的表现优于其非推理版本,但每个 Episode 都会多付出 3 到 6 倍的输出 Token 溢价——其中很大一部分消耗在了重新推导同一领域不同 Episode 之间所共享的流程上。我们证明了这种重复发生的成本是可以被分摊(amortized)的:一个编程 Agent 分析来自训练集分割(training split)的一小部分已有轨迹(trajectories),并编译出一段紧凑的自然语言技能(skill),随后将其注入到非推理模型的系统提示词中。
在四个 Agent 基准测试(ALFWorld、τ2-bench 电信与零售领域,以及 SpreadsheetBench-Verified)中,对于留出任务(held-out tasks),技能为 GPT-5.4-mini 挽回了推理能力差距(reasoning gap)的 55% 至 100%+ ——在其中两个基准上甚至直接超越了推理模式——同时产生的输出 Token 减少了 2.7 到 6 倍,且产生的推理 Token 为零。
值得注意的是,推理轨迹(reasoning traces)并非必要前提:仅从非推理轨迹中提炼出的技能,与从“推理/非推理”配对语料库中提炼出的技能相比依然极具竞争力,两者之间的差异取决于具体领域。
我们从搜索的视角来解释这些结果:测试时推理(test-time reasoning)是单个 Episode 内部的深度搜索(deep search),每次部署都要重新买单;而语料库蒸馏则是跨 Episode 的广度搜索(wide search),只需支付一次成本。两者恢复了重合的程序性知识(procedural knowledge),且在廉价轨迹上开展广度搜索通常是划算得多的选择——而在某些领域(如电信、SpreadsheetBench)上残存的差距,则划定了真正需要针对具体实例进行深度搜索的边界。
原文链接:https://arxiv.org/abs/2608.07885
前往小宇宙评论区与主播互动