Skip to content
Artwork for Seventy3
Seventy3 · Sunday · 17 min

【第721期】结构化输出引发的语言模型答案同质化研究

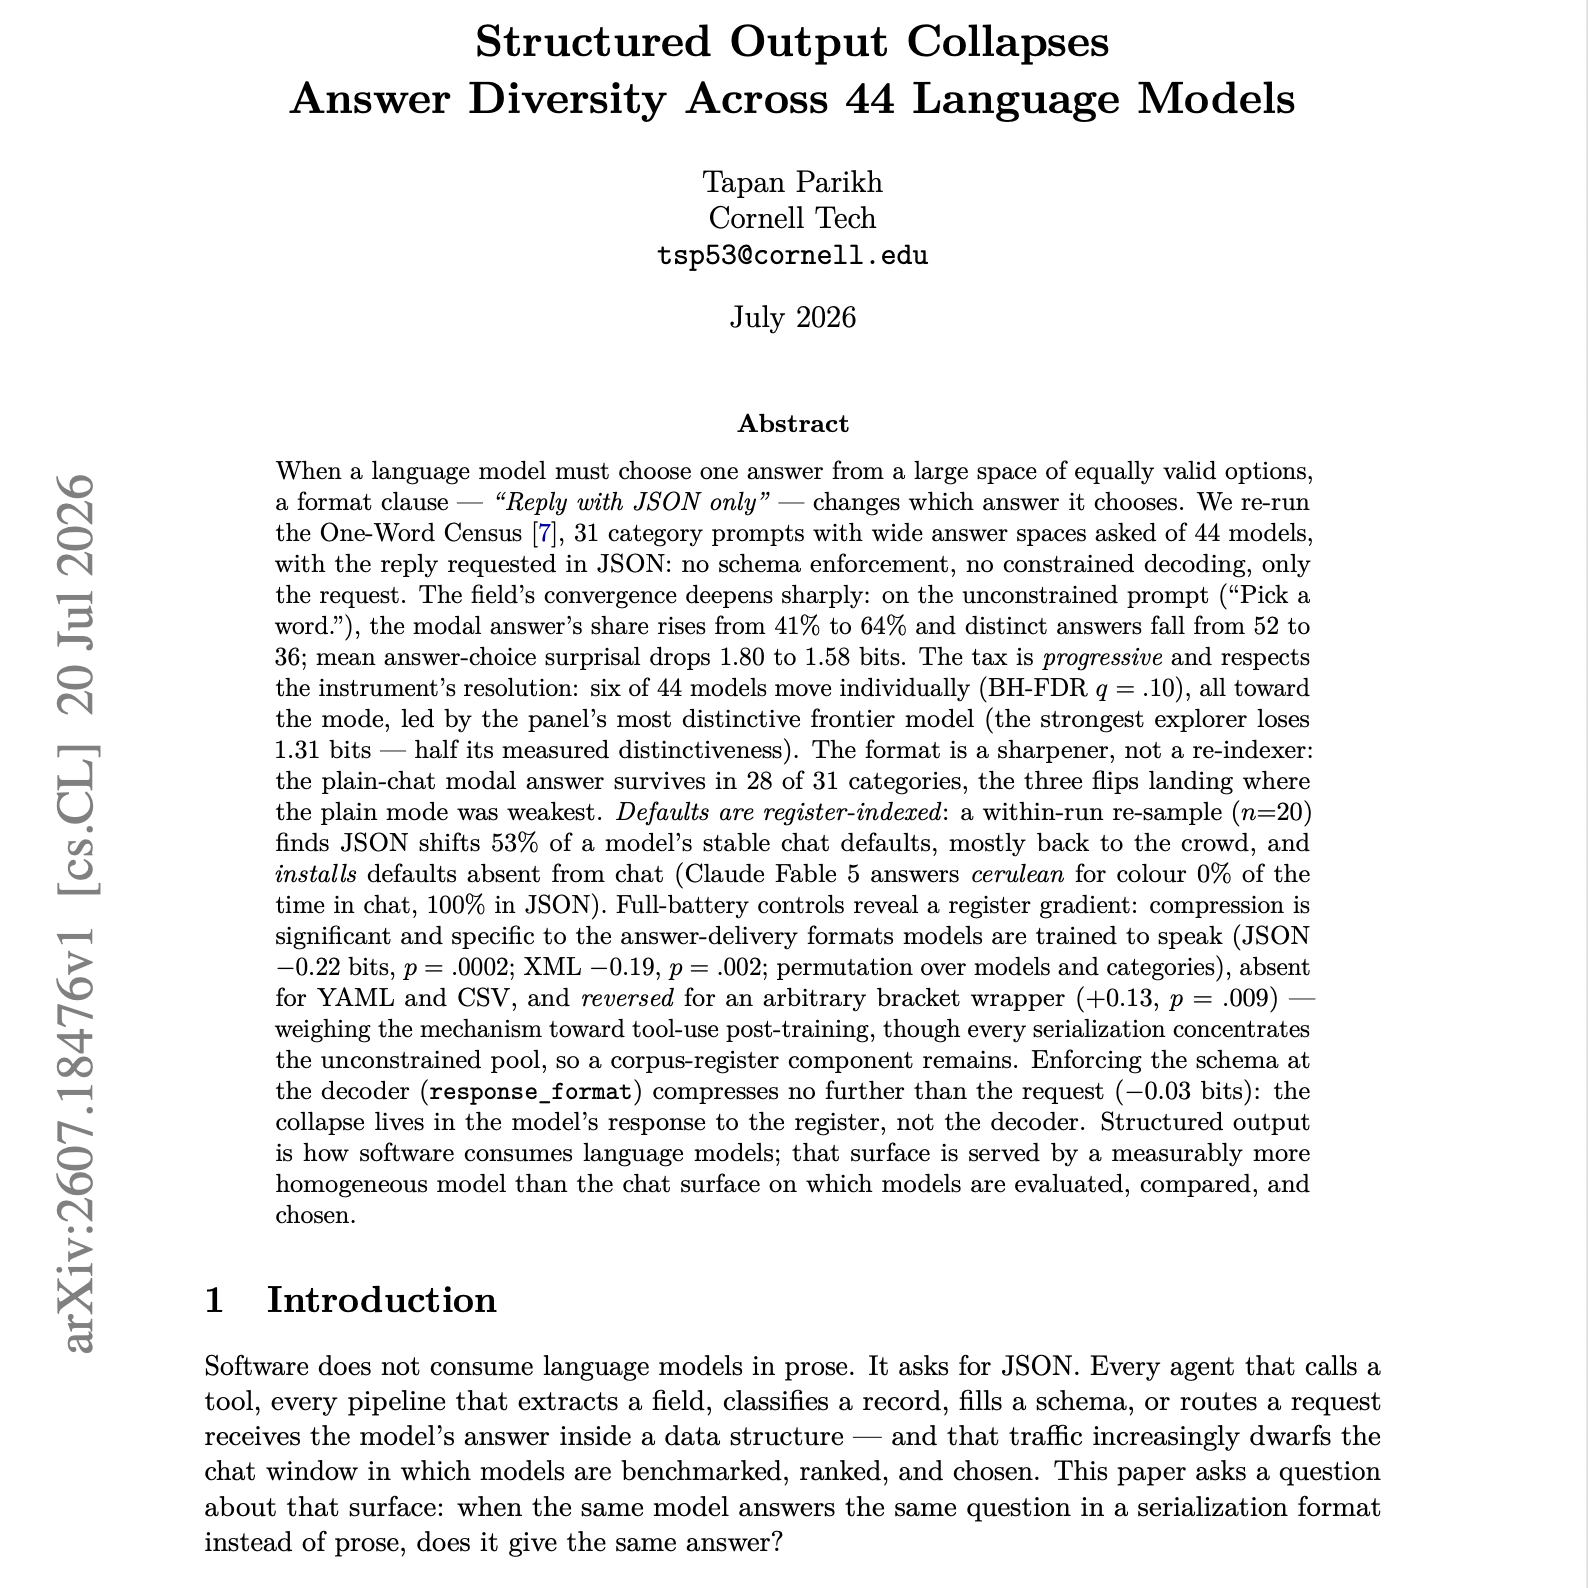
今天的这篇的主题是: Structured Output Collapses Answer Diversity Across 44 Language Models Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 当语言模型必须从庞大的等效有效选项空间中选择一个答案时,格式子句(例如“仅以 JSON 格式回复”)会改变其最终选择的答案。我们重新运行了“单词人口普查”(One-Word Census,arXiv:2607.12796):针对 44 个模型提出了 31 个具有宽泛答案空间的类别提示词,而本次则要求以 JSON 格式回复——无模式(schema)强制约束,无约束解码,仅包含这一请求。 收敛程度急剧加深:在无约束的“选择一个词”提示下,众数答案(modal answer)在总体中的占比从 41% 上升至 64%,而独立答案的数量则从 52 个降至 36 个;平均答案选择惊奇度(surprisal)从 1.80 比特降至 1.58 比特。这种“格式税”呈现出渐进性:在 44 个模型中有 6 个模型在个体层面上发生了显著偏移(BH-FDR q=0.10),且全部向众数靠拢,并以最具个性(最独特)的模型为首,而顺从型模型的基线则保持不动。 这是一种“尖锐化”而非“重新索引”——普通对话模式下的众数答案在 31 个类别中的 28 个里得以延续。默认选择呈现出语域索引特征(register-indexed):一次运行内的重采样(n=20)发现,JSON 使得模型 53% 的稳定对话默认选择发生了偏移,且绝大多数退回到了从众选择,并确立了对话模式中不存在的默认选项(例如 Claude Fable 5 在对话模式下回答颜色的选项为“蔚蓝色”的概率为 0%,但在 JSON 模式下为 100%)。 全套对照实验揭示了一种语域梯度(register gradient):压缩效应显著存在,且专门作用于经过训练、专门用于输出的答案交付格式(JSON 减少 0.22 比特,p=0.0002;XML 减少 0.19 比特,p=0.002);该效应在 YAML 和 CSV 中不存在,而在任意括号包裹格式中则发生反转(增加 0.13 比特,p=0.009)——这使得其作用机制更偏向于工具调用的后训练(tool-use post-training)。 在解码器端强制执行模式(response_format)相比单纯的文本请求并不会带来进一步的压缩(仅减少 0.03 比特):这种坍缩存在于模型对语域的反应中,而非来自于解码器本身。结构化输出是软件消费语言模型的主要方式,而这一表面所服务的是一个在测量上比对话表面更加同质化的模型——而后者恰恰是模型被评估、比较和选择时所基于的表面。 原文链接:https://arxiv.org/abs/2607.18476 前往小宇宙评论区与主播互动

0:00-17:20

transcript

No transcript — this publisher did not publish one.

show notes

今天的这篇的主题是: Structured Output Collapses Answer Diversity Across 44 Language Models

Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。

如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。

联系小助手微信:eccstartup(加群/投稿论文)

Summary

当语言模型必须从庞大的等效有效选项空间中选择一个答案时,格式子句(例如“仅以 JSON 格式回复”)会改变其最终选择的答案。我们重新运行了“单词人口普查”(One-Word Census,arXiv:2607.12796):针对 44 个模型提出了 31 个具有宽泛答案空间的类别提示词,而本次则要求以 JSON 格式回复——无模式(schema)强制约束,无约束解码,仅包含这一请求。

收敛程度急剧加深:在无约束的“选择一个词”提示下,众数答案(modal answer)在总体中的占比从 41% 上升至 64%,而独立答案的数量则从 52 个降至 36 个;平均答案选择惊奇度(surprisal)从 1.80 比特降至 1.58 比特。这种“格式税”呈现出渐进性:在 44 个模型中有 6 个模型在个体层面上发生了显著偏移(BH-FDR q=0.10),且全部向众数靠拢,并以最具个性(最独特)的模型为首,而顺从型模型的基线则保持不动。

这是一种“尖锐化”而非“重新索引”——普通对话模式下的众数答案在 31 个类别中的 28 个里得以延续。默认选择呈现出语域索引特征(register-indexed):一次运行内的重采样(n=20)发现,JSON 使得模型 53% 的稳定对话默认选择发生了偏移,且绝大多数退回到了从众选择,并确立了对话模式中不存在的默认选项(例如 Claude Fable 5 在对话模式下回答颜色的选项为“蔚蓝色”的概率为 0%,但在 JSON 模式下为 100%)。

全套对照实验揭示了一种语域梯度(register gradient):压缩效应显著存在,且专门作用于经过训练、专门用于输出的答案交付格式(JSON 减少 0.22 比特,p=0.0002;XML 减少 0.19 比特,p=0.002);该效应在 YAML 和 CSV 中不存在,而在任意括号包裹格式中则发生反转(增加 0.13 比特,p=0.009)——这使得其作用机制更偏向于工具调用的后训练(tool-use post-training)。

在解码器端强制执行模式(response_format)相比单纯的文本请求并不会带来进一步的压缩(仅减少 0.03 比特):这种坍缩存在于模型对语域的反应中,而非来自于解码器本身。结构化输出是软件消费语言模型的主要方式,而这一表面所服务的是一个在测量上比对话表面更加同质化的模型——而后者恰恰是模型被评估、比较和选择时所基于的表面。

原文链接:https://arxiv.org/abs/2607.18476


前往小宇宙评论区与主播互动
links2